表 A:CODE (PK), NAME
表 B:STUDENT_CODE (PK), STUDENT_NAME, SCORE
資料:
A: ('1101','韓甲'), ('1102','丁乙')
B: ('1101','韓甲',99), ('1102','丁乙',89), ('1103','徐靜',94)
SELECT code, name FROM A
INTERSECT
SELECT student_code, student_name FROM B;
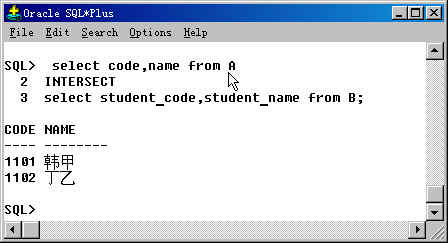
圖 1:INTERSECT 查詢結果
SELECT code, name FROM A
WHERE A.code IN (SELECT student_code FROM B)
  AND A.name IN (SELECT student_name FROM B)
ORDER BY A.code;
IN 子查詢,欄位多時 SQL 膨脹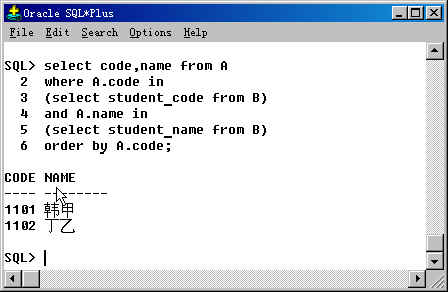
圖 2:IN 子查詢結果 (此範例資料下結果相同)
| 維度 | INTERSECT | 多重 IN |
|---|---|---|
| 語意正確性 | 逐列組合比對 (Tuple-level) | 單獨欄位獨立比對 (Column-level),易誤判 |
| SQL 簡潔度 | 單一關鍵字 | 需 N 個 IN 子查詢 |
| 效能 | 通常優 (集合運算優化) | 視轉換計劃而定,通常較慢 |
| 去重行為 | 自動 DISTINCT | 不去重,需自行處理 |
| 適用版本 | Oracle 7.3+ | 所有版本 |
-- A 有但 B 沒有
SELECT * FROM A MINUS SELECT * FROM B;

-- 合併 (去重)
SELECT * FROM A UNION SELECT * FROM B;

-- 合併 (不去重,效能最好)
SELECT * FROM A UNION ALL SELECT * FROM B;
INTERSECT / MINUS / UNION** 進行集合運算,語意精確、優化器友善UNION ALL 並自行處理去重IN/EXISTS 模擬 Tuple 比較,除非版本極舊不支援集合運算子集合運算子是 SQL 標準的強大武器,INTERSECT 解決「兩表共同資料」是教科書級用法。拋棄多重 IN 的模糊語意與效能隱憂,擁抱標準集合思維。