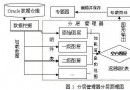
影響資料庫效能的關鍵因素主要包含系統層面、資料庫本身以及網路傳輸三大維度。而在資料庫內部優化中,磁碟 I/O 優化佔據核心地位,其他還包括回滾段優化、Redo 日誌優化、系統全域區 (SGA) 優化以及資料庫物件優化。
若要掌握系統運行狀態,必須先開啟統計收集功能。在 init.ora 參數檔中設定 TIMED_STATISTICS=TRUE,並在 Session 層級執行 ALTER SESSION SET TIMED_STATISTICS=TRUE。接著以 connect internal 方式登入 svrmgrl,於業務正常運行期間執行 utlbstat.sql 開始採樣,經過一段時間後執行 utlestat.sql 停止採樣。分析報告將自動生成於 report.txt 中(這兩個腳本通常位於 $ORACLE_HOME/RDBMS/ADMIN 目錄下)。
在 UNIX 系統可使用 sar -d 檢視整體 I/O 統計;Windows 環境則透過「效能監視器」觀察磁碟佇列長度、平均秒數/傳輸等關鍵計數器。
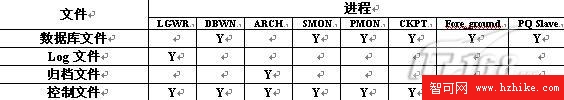
Oracle 透過多個背景進程處理 I/O:DBWn (資料庫寫入進程) 負責將髒緩衝區寫入資料檔;LGWR (日誌寫入進程) 循序寫入 Redo Log;ARCH (封存進程) 處理封存日誌;CKPT (檢查點進程) 更新控制檔與資料檔標頭。理解這些進程職責有助於定位爭用熱點。
執行以下查詢即可獲得每個資料檔的物理讀寫次數,進而判斷哪些檔案承受最大 I/O 壓力:
SELECT NAME, PHYRDS, PHYWRTS
FROM V$DATAFILE DF, V$FILESTAT FS
WHERE DF.FILE# = FS.FILE#;當段 (Segment) 空間耗盡觸發動態擴展時,會產生遞迴呼叫與鎖競爭。可透過 V$SYSSTAT 中的 recursive calls 指標監控頻率。解決方案為:預估實體最大尺寸,建立時一次配置足夠的 Extent (區間);或使用區域管理表空間 (LMT) 搭配自動區間分配。
SET TRANSACTION USE ROLLBACK SEGMENT ...)。遷移列因 UPDATE 導致行長度超過區塊剩餘空間而移動;鏈結列因單行過大跨越多個區塊。處理步驟:
ANALYZE TABLE ... LIST CHAINED ROWS 收集資訊至 CHAINED_ROWS 表。CHAINED_ROWS,屬鏈結列,唯有增大區塊大小 (DB_BLOCK_SIZE) 解決。查詢 V$SYSSTAT 中 SORTS (MEMORY) 與 SORTS (DISK) 比值。若磁碟排序佔比過高,應調大 SORT_AREA_SIZE (專用伺服器) 或 PGA_AGGREGATE_TARGET (共用伺服器/自動 PGA 管理)。
若資料已依索引鍵排序,可用 CREATE INDEX ... NOSORT 避免排序開銷。
Checkpoint 會觸發 DBWn 將所有髒緩衝區刷盤並更新控制檔。過於頻繁增加 I/O 壓力,過於稀疏延長復原時間。透過 LOG_CHECKPOINT_INTERVAL、LOG_CHECKPOINT_TIMEOUT、FAST_START_MTTR_TARGET (10g+) 精細控制。
單次 I/O 大小取決於 LOG_BUFFER。過大延遲寫入,過小導致頻繁小 I/O。若平均 I/O 尺寸過大致 Redo Log 成為瓶頸,可實施 Redo Log 條帶化 (多成員分布於不同磁碟)。
設定 DB_WRITER_PROCESSES (10g 預設為 CPU 核心數/8 取整) 啟用多寫入進程,分攤刷盤負載。
V$RESOURCE_LIMIT 顯示各資源當前使用量與上限,快速判斷是否觸及上限。
V$SYSTEM_EVENT 找出平均等待時間最長的事件。V$WAITSTAT 定位等待最多的區塊類別 (Data Block, Undo Header 等)。V$SESSION_WAIT 精確到具體 Session、File#、Block#。SELECT CLASS, COUNT
FROM V$WAITSTAT
WHERE CLASS IN ('SYSTEM UNDO HEADER','SYSTEM UNDO BLOCK','UNDO HEADER','UNDO BLOCK');V$DISPATCHER 忙碌率 > 50% 需增加 MTS_DISPATCHERS。V$QUEUE 平均等待時間過長需擴充調度器或共用伺服器 (MTS_MAX_SERVERS)。V$SYSSTAT 中 redo buffer allocation retries 應趨近 0,持續增長代表空間不足,需增大 LOG_BUFFER。Latch 細分為 Allocation Latch (空間分配) 與 Copy Latch (內容複製,數量由 LOG_SIMULTANEOUS_COPIES 控制,最大至 2×CPU)。
查詢 V$LATCH / V$LATCHNAME 計算 Miss Rate 判斷嚴重度:
SELECT ln.name, gets, misses, immediate_gets, immediate_misses
FROM v$latch l, v$latchname ln
WHERE ln.name IN ('redo allocation','redo copy') AND ln.latch# = l.latch#;LOG_SMALL_ENTRY_MAX_SIZE 縮短持有時間。LOG_SIMULTANEOUS_COPIES 增加 Latch 數量。V$WAITSTAT 確認 Data Block 爭用。V$SYSTEM_EVENT 確認 Buffer Busy Waits 高企。V$SESSION_WAIT 取得具體 File/Block/ID。DBA_EXTENTS 定位段名與類型 → 查 DBA_SEGMENTS 取得 FREELISTS 數值。FREELISTS / FREELIST GROUPS (RAC) 參數,或採用 ASSM (自動段空間管理) 徹底解決。定期執行以下查詢,依 PHYRDS + PHYWRTS 總量評估各表空間 I/O 壓力,指導檔案遷移:
SELECT NAME, PHYRDS, PHYWRTS
FROM V$DATAFILE, V$FILESTAT
WHERE V$DATAFILE.FILE# = V$FILESTAT.FILE#;
範例輸出顯示 SYSTEM 表空間讀寫顯著高於其他,若為核心業務表空間則正常;若為審計/臨時表空間異常高則需調查。