| 操作 | 建立的物件 | 資料字典記錄 | 刪除時行為 |
|---|---|---|---|
| CREATE UNIQUE CONSTRAINT | 1 個 Constraint + 1 個唯一索引 | USER_CONSTRAINTS + USER_INDEXES | 可 DROP CONSTRAINT KEEP INDEX 保留索引 |
| CREATE UNIQUE INDEX | 僅 1 個唯一索引 | USER_INDEXES(無 Constraint 記錄) | DROP INDEX 直接移除,資料可重複 |
本質關係:唯一約束內部透過建立唯一索引來強制執行。約束是邏輯層規則,索引是物理層實現。
TOAD 的「建立約束」與「建立索引」視窗分別提供「唯一」選項,易造成誤以為兩者等價:
CONSTRAINT + 隱含索引INDEX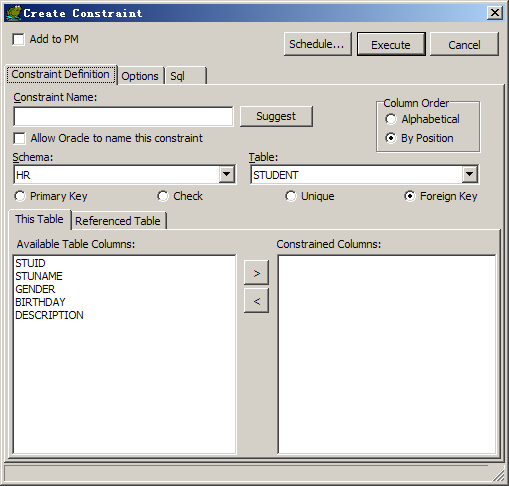
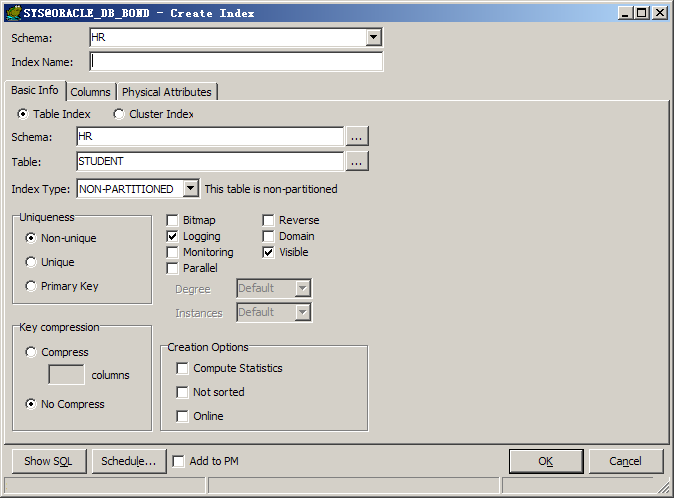
-- 方式 1:建立主鍵約束(推薦)
ALTER TABLE emp ADD CONSTRAINT pk_emp PRIMARY KEY(empno);
-- 產生:PK Constraint + 唯一索引(名稱通常同 PK 名或 SYS_Cxxxx)

-- 方式 2:建立唯一索引再指定為 PK(罕見)
CREATE UNIQUE INDEX pk_emp_idx ON emp(empno);
ALTER TABLE emp ADD CONSTRAINT pk_emp PRIMARY KEY(empno) USING INDEX pk_emp_idx;
-- 結果相同:PK Constraint + 指定索引兩種路徑最終產生相同的物件組合,無功能差異。主鍵約束必須有唯一索引支撐。
-- 業務暫時允許重複 Email,但查詢仍需索引加速
ALTER TABLE users DROP CONSTRAINT uk_users_email KEEP INDEX;
-- 索引保留,查詢不受影響;資料可插入重複 Email

-- 之後恢復業務規則
ALTER TABLE users ADD CONSTRAINT uk_users_email UNIQUE(email) USING INDEX uk_users_email;-- 記錄表:查詢常用 correlation_id,但業務允許重複(不同來源系統)
CREATE UNIQUE INDEX idx_logs_corr_id ON logs(correlation_id);
-- 錯誤!唯一索引會阻擋重複值
-- 正確:建立非唯一索引
CREATE INDEX idx_logs_corr_id ON logs(correlation_id);-- 唯一約束:可停用驗證,保留索引結構
ALTER TABLE emp DISABLE CONSTRAINT uk_emp_email KEEP INDEX;
-- 大量匯入...
ALTER TABLE emp ENABLE NOVALIDATE CONSTRAINT uk_emp_email; -- 不驗證既有資料
-- 唯一索引:只能刪除重建
DROP INDEX uk_emp_email;
-- 匯入...
CREATE UNIQUE INDEX uk_emp_email ON emp(email); -- 若資料有重複會失敗對應用程式而言,兩者皆阻擋重複值插入,拋出 ORA-00001。差異在於:
USER_CONSTRAINTS 可查約束,工具常依此產生 ER 圖@UniqueConstraint 對應約束,@Index(unique=true) 對應索引CREATE INDEX。UK_<表>_<欄位> 同時用於約束與其支撐索引,IDX_<表>_<欄位> 用於非唯一索引。SELECT
c.constraint_name,
c.constraint_type, -- 'U' = Unique, 'P' = Primary Key
c.status,
i.index_name,
i.uniqueness,
i.status AS index_status
FROM user_constraints c
LEFT JOIN user_indexes i
ON c.index_name = i.index_name
AND c.table_name = i.table_name
WHERE c.table_name = 'EMP'
AND c.constraint_type IN ('U','P');Oracle 中唯一約束 = 唯一索引 + 語義標籤。主鍵約束同理。理解「約束是什麼、索引是怎麼做到的」關係,能正確選擇建立方式、設計刪除/停用策略、與 ORM 框架無縫對接。原則:有業務語義用約束,純效能用索引。