Oracle 資料庫字元集變更是高風險作業,**修改前必須完整備份、於測試環境驗證、規劃停機窗口**。本文記錄標準修改流程、INTERNAL_USE 跳過超集檢查的適用條件、資料截斷風險評估與驗證步驟,供 DBA 參考執行。
-- 1. 關閉應用層連線
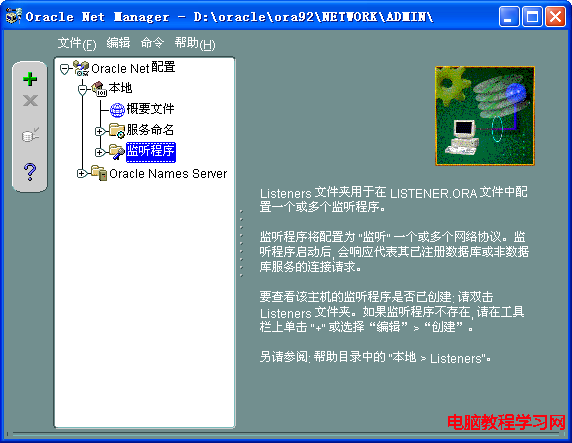
-- 2. 關閉監聽器
$ lsnrctl stop

-- 3. 以 SYSDBA 登入關閉資料庫
SQL> SHUTDOWN IMMEDIATE;

-- 4. 啟動至 MOUNT 階段(獨佔模式)
SQL> STARTUP MOUNT EXCLUSIVE;

-- 5. 開啟受限會話、關閉背景作業
SQL> ALTER SYSTEM ENABLE RESTRICTED SESSION;
SQL> ALTER SYSTEM SET JOB_QUEUE_PROCESSES = 0;
SQL> ALTER SYSTEM SET AQ_TM_PROCESSES = 0;

-- 6. 開啟資料庫
SQL> ALTER DATABASE OPEN;

-- 7. 修改字元集(標準方式:新集需為舊集超集)
SQL> ALTER DATABASE CHARACTER SET AL32UTF8;
-- 若報 ORA-12712: new character set must be a superset of old character set
-- 表示舊集字元無法完整映射至新集,需評估資料風險後再決定是否強制

-- 8. 關閉並正常重啟驗證
SQL> SHUTDOWN IMMEDIATE;
SQL> STARTUP;-- 僅在確認資料相容或接受資料損壞風險時使用
SQL> ALTER DATABASE CHARACTER SET INTERNAL_USE AL32UTF8;
Database altered.警告: INTERNAL_USE 會跳過超集驗證,**若舊資料含新字元集無法表示的字碼(如 BIG5 環境存中文、改 UTF8 通常安全;反向則高風險),將導致資料永久損壞、顯示亂碼**。執行前必須:
CSSCAN (Character Set Scanner) 掃描評估:csscan userid=sys/pwd full=yscan.log 中的「Lossy conversion」筆數,為 0 才相對安全。| 字元集 | 適用場景 | 備註 |
|---|---|---|
| AL32UTF8 | 新建系統、多語言、Emoji、完整 Unicode | Oracle 推薦,對應 UTF-8 (RFC 3629) |
| UTF8 | 舊版相容 (9i/10g)、僅 BMP 字元 | 對應 CESU-8,不支援補充平面字元 |
| ZHS16GBK | 純簡體中文環境、舊系統相容 | 雙位元組,儲存較緊湊 |
| ZHT16MSWIN950 | 繁體中文環境 | Big5 擴充 |
SELECT * FROM NLS_DATABASE_PARAMETERS WHERE PARAMETER LIKE '%CHARACTERSET%'; 確認 NLS_CHARACTERSET=AL32UTF8SELECT col FROM tbl WHERE LENGTH(col) != LENGTHB(col); 檢查位元組長度是否預期NLS_LENGTH_SEMANTICS:建議設為 CHAR(ALTER SYSTEM SET NLS_LENGTH_SEMANTICS=CHAR SCOPE=SPFILE),避免 VARCHAR2(10) 僅能存 10 bytes 而非 10 字元CREATE DATABASE ... CHARACTER SET AL32UTF8EXPDP/IMPDP 或 EXP/IMP 遷移結構與資料此法雖耗時較長,但完全規避 INTERNAL_USE 風險,且可順便整理碎片、調整表空間,是大型核心系統的首選。
NLS_LANG 必須對應調整(如 AMERICAN_AMERICA.AL32UTF8),否則仍會亂碼。字元集變更屬於核心變更,**嚴禁在無完整備份與測試驗證的情況下直接對生產庫操作**。遵循「掃描評估 → 測試環境演練 → 生產執行 → 全鏈路驗證」四階段流程,方能確保萬無一失。