近期業界熱談「場景化運維」與「場景化大數據分析」,Gdevops 峰會上新炬網絡執行副總裁程永新一句「一切沒有場景驅動的運維平台建設都是假大空」,振聾發聩。技術固然重要,但脫離業務場景、無法呈現業務價值的技術,實際上並不重要。對運維人員而言,離開場景學習再高深的技術,也只是浪費時間。新同事入職後,能讓技術發揮作用的環境與流程考核,佔據了成功的三分之二。
壞塊問題是做過兩三年 Oracle 維護的 DBA 必遇挑戰。面試常問:壞塊如何產生?處理過哪些案例?若負責的多個資料庫同時爆發大量壞塊,你會怎麼做?前幾題答得不錯的人很多,但最後一題能出彩的寥寥無幾——因為思維太窄。若此時仍逐庫查 alert 日誌、逐塊定位對象、再用修復手段,所有人都會被你拖垮。
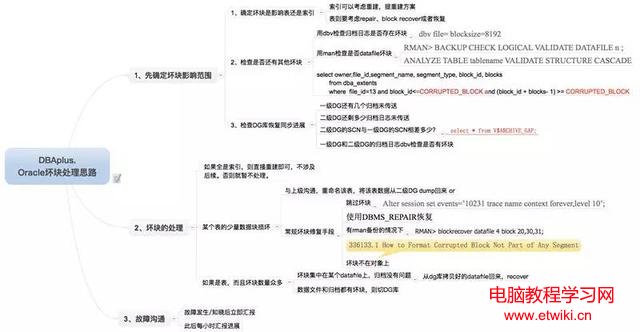
曾經歷某庫出現幾萬個壞塊,花了兩天仍未修復完。當時其他專家仍在苦熬恢復,我向領導提議啟用新方案,在大老板耐心耗盡前恢復了業務。真正正確的做法是:確定壞塊數量極多時,立即停業務、切災備,事後再補數據。 災備平時養著不就是為這關鍵時刻用的嗎?
遺憾的是,大多數面試者糾結於用 BLOCK RECOVER、DBMS_REPAIR、BBED 等技術細節,而忽略了決策層面的判斷。
不論災備是否完善,切換涉及應用、網絡、主機、存儲多方協調,絕非說切就能切。一般企業預估故障處理超過 2 小時 無法恢復業務,應申報切災備;金融證券行業 1 分鐘 未恢復需知會證監會,半小時 未恢復會被通報,因此必須在這時間窗內決策。
前提是:企業必須預先建設有效的災備環境,並制定災備切換預案。DBA 需敏捷檢查庫狀態並及時匯報,這正是自動化運維平台的價值——一鍵獲取告警日誌中的壞塊涉及對象,豈不更好?
經驗豐富的運維管理者,第一反應應是「為何同時發生?」顯然是外因導致。業務恢復第一時間,應排查這些庫共同的基礎設施:是否同存儲、同存儲管理軟體、同卷管理軟體。經驗顯示,多庫同時壞塊,多半源於存儲管理軟體故障。
fsck 修復。這屬於何類壞塊?留給讀者思考。資深 DBA 解決問題,不急於敲命令,而站在更高維度審視,往往事半功倍。
某核心資料庫「莫名」中止,重啟發現大量數據文件壞塊,伴隨內部錯誤(ORA-00600 等),資料庫無法開啟。
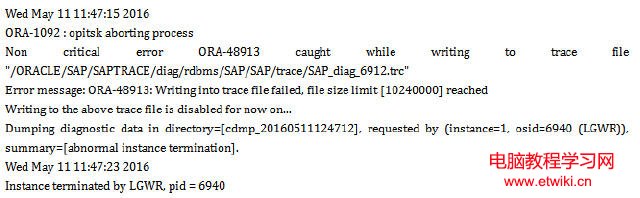
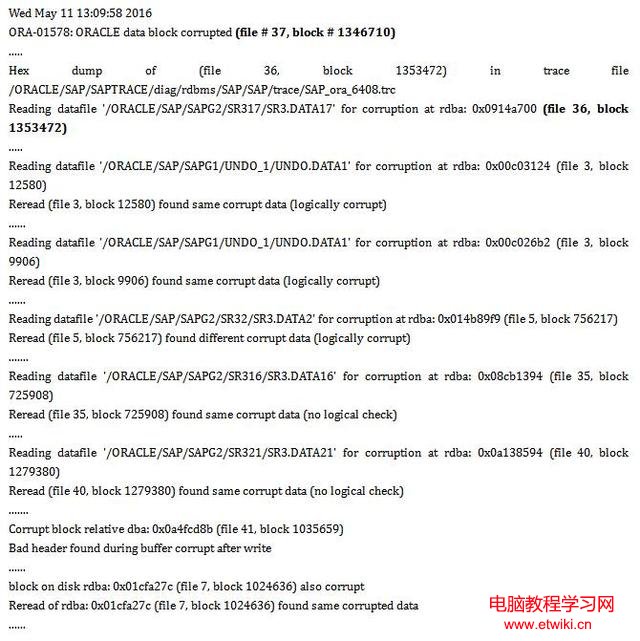
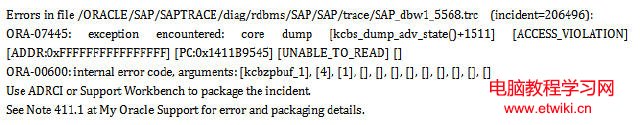
破解之道:用當天備份結合歸檔恢復,遠比逐個修復壞塊快得多。
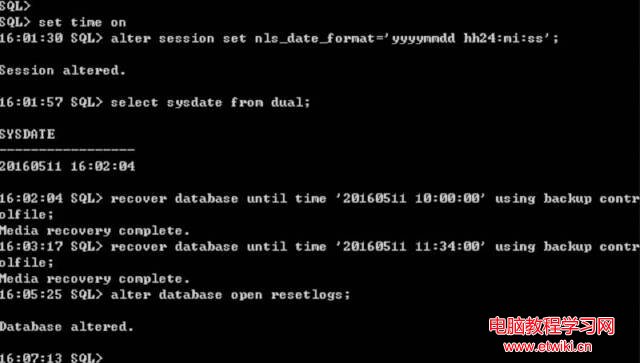
解決問題的原則:優先使用能最快恢復業務的技術,而非技術含量最高的技術。
該案例無容災環境,幸虧有備份,否則後果不堪設想。