核心原理:數據越小 = IO 越少 = 緩存命中越高 = 查詢越快
壓縮數據體積是數據庫優化投入產出比最高的手段之一。本文五大實戰技法直擊存儲層。
式一:NOT NULL 是免費的性能紅利
- 誤區:NULL 不佔空間 → 實際每列額外 1 bit 標記位 (MyISAM) / 額外字節 (InnoDB)
- 實測:
INT NOT NULL 4 字節 vs INT NULL 5 字節 (InnoDB)
- 策略:業務允許處 全量 NOT NULL,無值用默認值 (0、空串、'1970-01-01')
- 例外:真正「未知/不適用」語義 (如「離職日期」) 保留 NULL
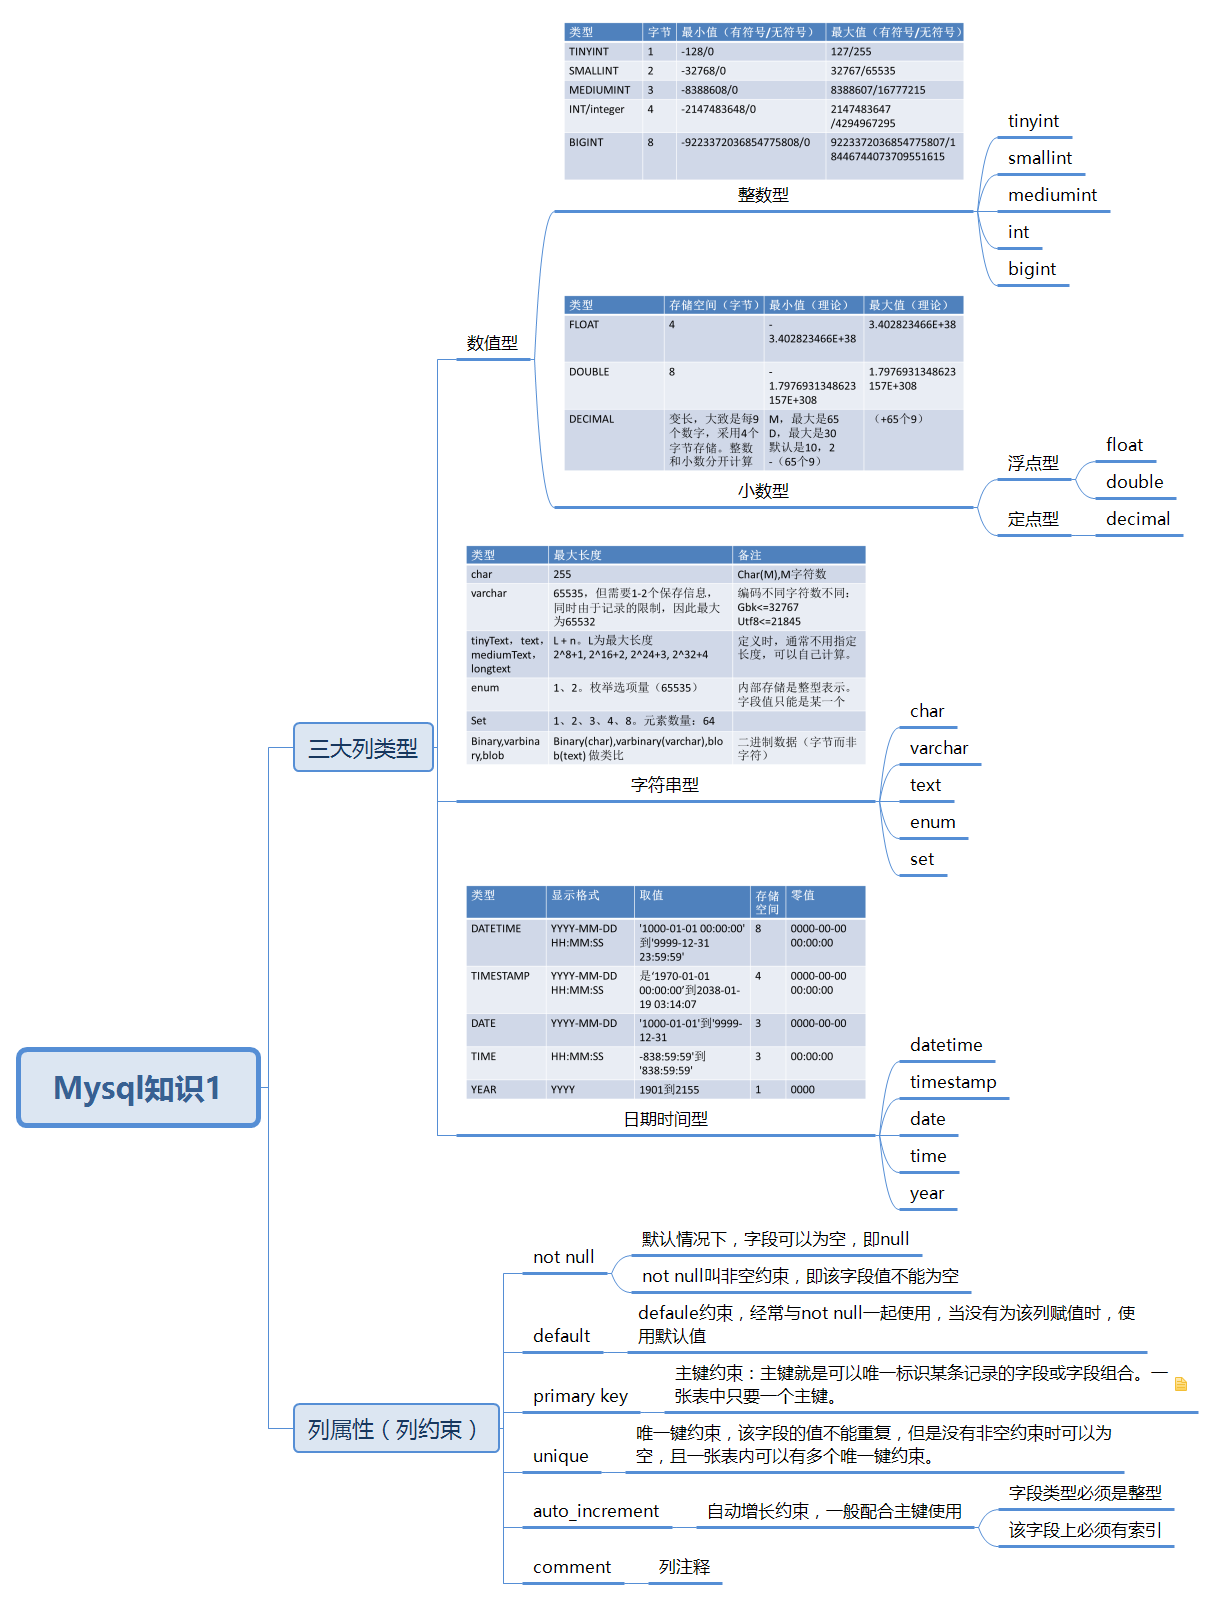
式二:精準選型,拒絕「大材小用」
| 場景 | 推薦類型 | 節省 vs 通用類型 |
|---|
| 整數 ID/計數,< 1600 萬 | MEDIUMINT (3 字節) | vs INT (4 字節) 省 25% |
| 狀態/枚舉,< 256 值 | TINYINT (1 字節) | vs SMALLINT (2 字節) 省 50% |
| 金額/精度固定 | DECIMAL(10,2) (5 字節) | vs DOUBLE (8 字節) 省 37% |
| 固定長度代碼 (員工工號 5 位) | CHAR(5) (5 字節) | vs VARCHAR(20) 省 60%+ |
| 日期僅需年月日 | DATE (3 字節) | vs DATETIME (8 字節) 省 62% |
| 時間戳自動維護 | TIMESTAMP (4 字節) | vs DATETIME 省 50% |
式三:前綴索引,以小博大
- 原理:列前 N 字符選擇性接近全列時,僅索引前綴
- 適用:URL、長文本、郵箱、身份證、UUID 等高基數長字符串
- 語法:
INDEX idx_email_prefix (email(10))
- 驗證:
SELECT COUNT(DISTINCT LEFT(email,10))/COUNT(*) FROM users; → 選擇性 > 0.9 可用
- 收益:索引體積降 50%+,緩存容納行數翻倍,查詢加速
式四:定長優勢,MyISAM 固定長表極速
- 條件:表無任何可變長列 (VARCHAR/TEXT/BLOB)
- 機制:固定行長 → 物理偏移 = 行號 × 行長 → O(1) 定位,無需行指針
- 代價:空間換時間 (CHAR 填充空格),但查詢速度質變
- 決策:高頻讀、行長固定、可接受空間換時 → 全表 CHAR
式五:分表化整為零,單表輕量高效
| 分表維度 | 適用場景 | 路由邏輯 |
|---|
| 時間 (月/日) | 日誌/訂單/流水 | YEAR(date)/MONTH(date) |
| 哈希 (用戶 ID) | 用戶數據/會話 | user_id % N |
| 範圍 (地區/業務線) | 多租戶/區域業務 | region_id 映射 |
| 列表 (枚舉值) | 狀態/類型分離 | status IN (...) |
關鍵:路由邏輯下推應用層/中間件,避免跨分表 JOIN/事務。
綜合效果估算
原表:1 億行,行長 200 字節 → 20 GB + 索引 10 GB = 30 GB
優化後:
- NOT NULL 省 1 位/列 × 10 列 × 1 億 ≈ 12.5 MB
- MEDIUMINT 替代 INT 省 1 字節 × 1 億 = 100 MB
- 前綴索引 (20→10 字符) 省 50% 索引 = 5 GB
- 分表 12 表 → 單表 1.7 GB,緩存命中率質變
總體:存儲 -30%+,查詢 P99 -50%+
相關延伸主題
- MySQL 索引設計最佳實踐
- 大表分表中間件選型 (ShardingSphere/Vitess/ProxySQL)
- InnoDB 行格式與存儲壓縮 (COMPRESSED/DYNAMIC)
- 數據歸檔與冷熱分離策略
- 上一篇文章: 不選 MySQL 的五大理由:授權陷阱、成熟度差距、功能沉澱、認證體系與擴展性爭議
- 下一篇文章: MySQL 主從復制一舉三得:負載均衡、異地備份、高可用架構實戰指南
Copyright ©
程式碼之家 All Rights Reserved