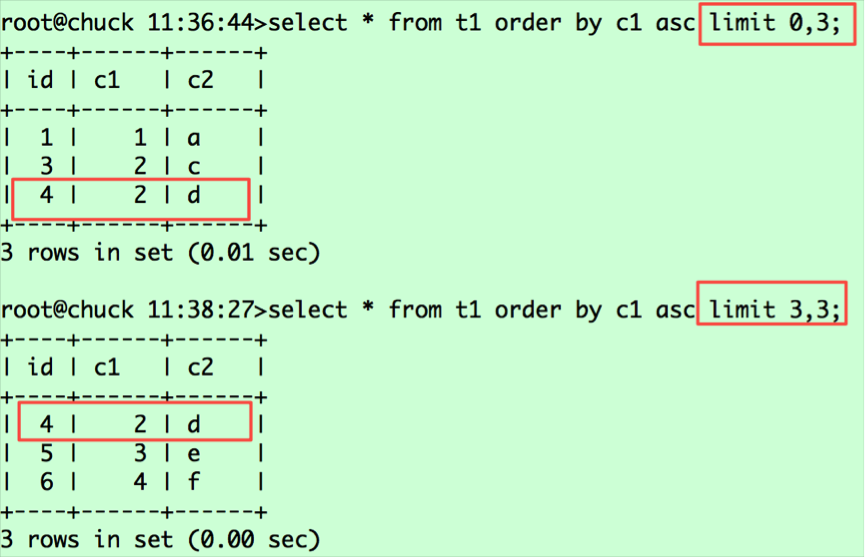
單表千萬級數據下,傳統 LIMIT offset, length 分頁性能急劇下降。本文梳理單機優化、分庫分表下的分頁策略,並給出工程落地方案。
-- 方案 A:大偏移全掃(慢)
SELECT * FROM t LIMIT 100000, 10;

-- 方案 B:主鍵游標(快,需連續遞增 ID)
SELECT * FROM t WHERE id > 100000 ORDER BY id LIMIT 10;

-- 方案 C:延遲關聯(通用,需覆蓋索引)
SELECT * FROM t
INNER JOIN (SELECT id FROM t WHERE ... ORDER BY id LIMIT 100000, 10) tmp USING (id);
跨分片查詢需各分片取 Top-N 後合併排序:
-- 應用層或中間件(ShardingSphere/MyCat)邏輯
SELECT * FROM t_shard_0 WHERE ... ORDER BY create_time DESC LIMIT 10
UNION ALL
SELECT * FROM t_shard_1 WHERE ... ORDER BY create_time DESC LIMIT 10
...
ORDER BY create_time DESC LIMIT 10;
缺點:深分頁時各分片仍需掃描大量數據,延遲不可控。
shard_key = user_id * 10000 + date),實現分片內有序,減少跨分片合併。| 場景 | 推薦方案 | 關鍵點 |
|---|---|---|
| 單表 < 500 萬 | 延遲關聯 + 覆蓋索引 | EXPLAIN 確認 Using index |
| 單表 > 500 萬 | 游標分頁(前端配合) | 業務改造,放棄跳頁 |
| 分庫分表 | 中間件合併 + 游標 | 各分片 LIMIT (offset+length),應用層二次排序截取 |
| 複雜條件/深分頁 | ES 搜索服務 | 數據異步同步,接受最終一致性 |
分頁優化無銀彈,核心是減少掃描行數與避免跨分片合併排序。業務若能接受「無跳頁、基於游標」、配合覆蓋索引或 ES,90% 的分頁性能問題迎刃而解。