這是國內乃至全球最大級的 Redis 生產集群之一。本文從業務應用場景出發,剖析微博如何用 Redis 解決高併發、大數據難題。
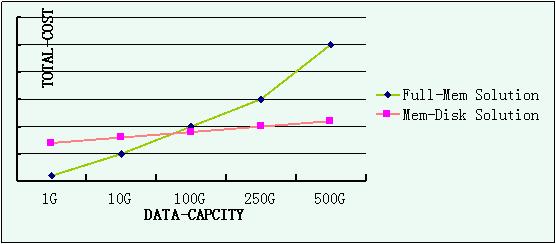
許多團隊擔心「全內存存儲計數成本過高」,但實際測算顛覆認知:
場景:短鏈接爆發式傳播,數萬用戶點擊跳轉,需即時判斷用戶等級、綁定狀態、偏好標籤以個性化展示。
傳統方案痛點:Memcache + MySQL 架構下,惡意/無效 ID 導致 Cache Miss,大量請求穿透至 MySQL,連接數暴漲、響應超時。
Redis 反向緩存方案:
// Key 設計
String key: "user:profile:{uid}"
Value: JSON {level: 3, bind_phone: true, gender: 1, tags: ["sport","tech"]}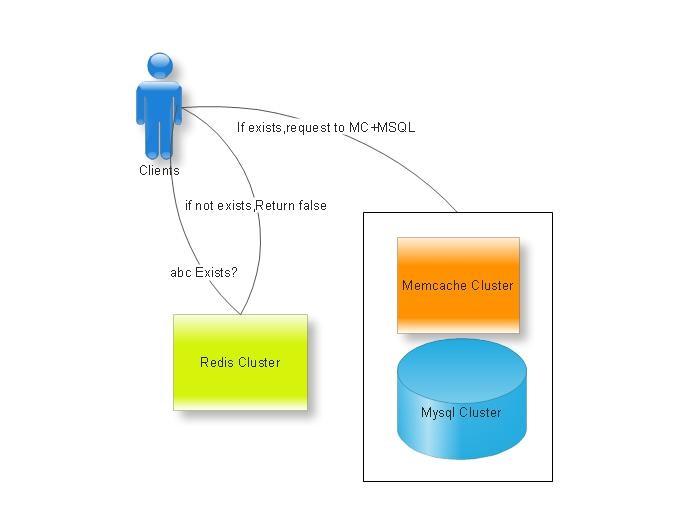
進階優化:引入 BloomFilter 進一步壓縮內存,誤判率可控。
運營活動頻繁要求「最新、最熱、點擊率最高」榜單。傳統 MC+MySQL 緩存失效率高,維護成本大。Redis Sorted Set(ZSET)天然支持:
ZINCRBY 實時更新分數ZREVRANGE 毫秒級取 Top NLPUSH recent:visit:{uid} {item_id}
LTRIM recent:visit:{uid} 0 99 // 保留最近 100 條
// 自動過期舊記錄,代碼零侵入LPUSH/RPOP 實現輕量級隊列,性能優於 RabbitMQ/Kafka 於中小流量場景。Redis Lua 腳本將多條命令打包為原子操作,典型場景:
-- 私信推送原子邏輯
local function push_msg(sender, receiver, msg_id)
  redis.call('INCR', 'unread:dialog:'..receiver)   -- 1. 會話未讀+1
  redis.call('INCR', 'unread:msg:'..receiver)      -- 2. 私信未讀+1
  redis.call('PUBLISH', 'push:ack:'..sender, msg_id) -- 3. 發送方回執
end注意:Lua 腳本全量寫入 AOF 並同步至 Slave,會增加磁盤/網卡負載,需評估腳本大小與調用頻率。
| 維度 | Redis | Memcache |
|---|---|---|
| 性能 | 單線程模型,極致優化,不遜色 MC | 多線程,但鎖競爭限制擴展性 |
| 內存效率 | 同等數據佔用更小(無 Slab 碎片) | Slab 分配導致 20-30% 內存浪費 |
| 功能豐富度 | 數據結構豐富、持久化、主從同步、集群 | 純 K/V、無持久化、無原生 HA |