四大方案對比
| 方案 | 核心邏輯 | 適用條件 | 相對耗時 (基準=方案1) |
|---|
| 1. ORDER BY RAND() | 建臨時表 → 全量賦隨機數 → 排序 → Limit | 任意表 | **100% (最慢)** |
| 2. PHP 端隨機 ID + >= 查詢 | 查 MAX/MIN ID → PHP `mt_rand` → `WHERE id >= $rand LIMIT 1` | **主鍵 ID 連續/較密集** | 79% |
| 3. SQL 端 RAND() 計算偏移量 | `SELECT FLOOR(RAND() * COUNT(*))` → `LIMIT $offset, 1` | 任意表 (無需連續 ID) | **13% (最快)** |
| 4. 子查詢隨機 ID (MySQL 4.1+) | `WHERE id >= (SELECT FLOOR(MAX(id) * RAND()) FROM t) ORDER BY id LIMIT 1` | **主鍵 ID 連續/較密集** | 16% |
代碼實現
方案 1:最慢 (反面教材)
SELECT * FROM `table` ORDER BY RAND() LIMIT 0, 1;
方案 2:PHP 協作 (需連續 ID)
$range = $pdo->query("SELECT MAX(id) max_id, MIN(id) min_id FROM `table`")->fetch();
$rand = mt_rand($range['min_id'], $range['max_id']);
$stmt = $pdo->prepare("SELECT * FROM `table` WHERE id >= ? LIMIT 1");
$stmt->execute([$rand]);
方案 3:純 SQL 偏移量 (冠軍 🏆)
$offset = $pdo->query("SELECT FLOOR(RAND() * COUNT(*)) AS `offset` FROM `table`")->fetchColumn();
$stmt = $pdo->prepare("SELECT * FROM `table` LIMIT ?, 1");
$stmt->execute([$offset]);
方案 4:子查詢 (MySQL 4.1+)
SELECT * FROM `table`
WHERE id >= (SELECT FLOOR(MAX(id) * RAND()) FROM `table`)
ORDER BY id LIMIT 1;
原理解析
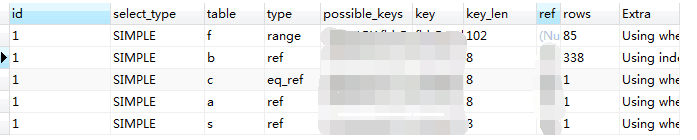
- 方案 1:全表掃描 + 臨時表 + Filesort,複雜度 O(N log N),N 越大越慘。
- 方案 2/4:利用 `MAX(id)` 估算分布,`RAND()` 乘以最大值近似均勻分布。**前提:ID 分布均勻、無大量空洞**,否則概率偏移。
- 方案 3:直接在 SQL 層計算隨機偏移量,**無需 ID 連續**,通用性最強,且只需兩次極快查詢 (聚合 + 偏移取值)。
生產環境建議
- **首選方案 3** (純 SQL 偏移量):**通用、最快、無業務假設**。
- 若表極大 (億級),`COUNT(*)` 可能較慢 (InnoDB 無計數器),可維護 `redis` 計數器或定時統計表近似值。
- 需**多條隨機不重複**時:方案 3 循環執行 + 應用層去重,或 `SELECT * FROM t WHERE id IN (隨機ID列表)`。
- 避免在高併發核心鏈路用隨機查詢,改為預計算隨機推薦池。