磁盤 100% 滿時,MySQL 並不會主動拒絕服務,而是每分鐘檢查一次空間、每 10 分鐘寫錯誤日誌。實測四大操作表現迥異:Select 不受影響、Insert 延遲卡死、Show Slave Status 死鎖、Show Status 連環卡死。本文還原現場、解析鎖機制、給出應急處置。
一、 官方行為
-- 每分鐘檢查一次可寫空間
-- 每 10 分鐘寫一次錯誤日誌
-- [Warning] Disk is full writing ...
MySQL 不主動殺查詢、不主動釋放空間,繼續嘗試寫入直到成功或被殺。
二、 四大操作實測行為
| 操作 | 表現 | 根因 |
|---|
| SELECT | ✅ 完全正常 | 純讀不寫磁盤,不涉及 Redo/Binlog 刷盤 |
| INSERT | ⏳ 延遲卡死(非首條即卡) | 卡在 sync_binlog/innodb_flush_log_at_trx_commit/Doublewrite 刷盤等待空間釋放 |
| SHOW SLAVE STATUS | 🔒 死鎖卡死 | 需 LOCK_active_mi → mi->data_lock,但 IO 線程持有 data_lock 寫 Relay Log 等待磁盤 |
| SHOW STATUS | 🔒 連環卡死(若先執行 Show Slave Status) | 需 LOCK_status + LOCK_active_mi,後者被 IO 線程持有 → 雙方互等 |
三、 關鍵刷盤參數
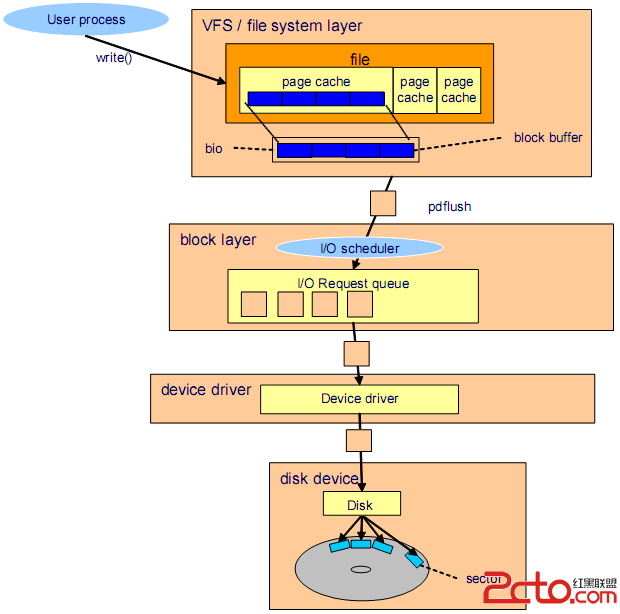
sync_binlog=1:每提交刷 Binlog → 磁盤滿時首條 Insert 即卡死。innodb_flush_log_at_trx_commit=1:每提交刷 Redo Log → 同樣首條卡死。- Doublewrite:髒頁刷盤前雙寫共享表空間 → 佔用額外空間。
四、 應急處置 SOP
- 立即釋放空間:
刪除舊 Binlog(PURGE BINARY LOGS BEFORE '...')、
刪除舊錯誤日誌/慢查詢日誌、
清理系統臨時文件、Docker 殘留層。
- 暫停寫入流量:應用層熔斷、讀寫分離切至從庫、維護模式。
- 觀察錯誤日誌:確認
Disk is full 警告消失、刷盤恢復正常。
- 重啟風險評估:磁盤滿時重啟 → Redo Log 無法恢復 → 數據必丟。極力避免重啟,優先擴容/清理。
五、 監控預警建議
- 磁盤使用率 > 80% → P1 告警(擴容/清理)
SHOW STATUS LIKE 'Innodb_buffer_pool_pages_dirty' 髒頁積壓 → P2 告警- Binlog 目錄單獨掛載、單獨監控、單獨保留策略
磁盤滿是「慢性自殺」,預留 20% 紅線、Binlog 獨立卷、熔斷機制,才是生存之道。
- 上一篇文章: MySQL InnoDB Buffer Pool LRU 算法深度解析:中點插入策略、Young/Old 區劃分、預讀頁保護機制
- 下一篇文章: MySQL 存儲過程示例:字符串分割轉換邏輯實現
Copyright ©
程式碼之家 All Rights Reserved