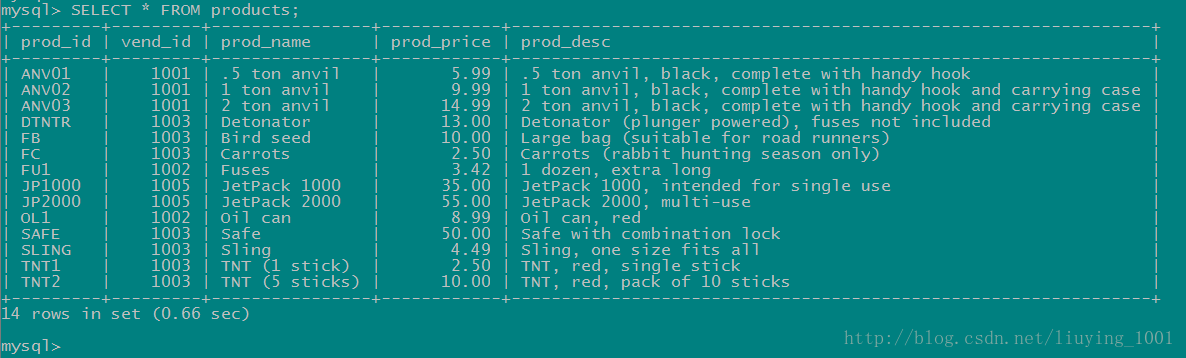
GROUP BY 將結果集按指定列分組,配合聚合函數對每組進行統計。HAVING 對分組後的聚合結果進行過濾(WHERE 過濾行,HAVING 過濾組)。以 products 表演示。
SELECT vend_id, COUNT(*) AS prod_count
FROM products
GROUP BY vend_id;
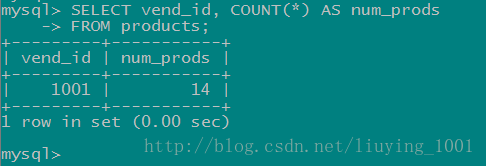
無 GROUP BY 時 COUNT(*) 返回全表總行數。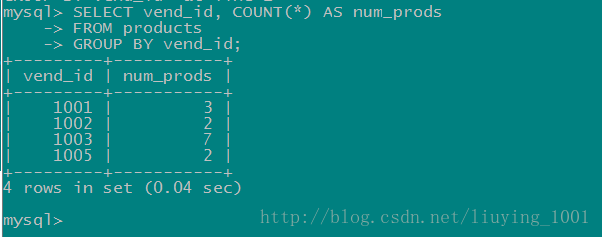
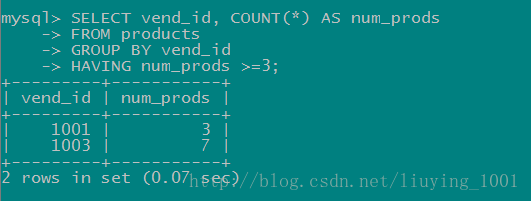
SELECT vend_id, COUNT(*) AS prod_count
FROM products
GROUP BY vend_id
HAVING COUNT(*) > 3;
需求:找出擁有 至少 2 款價格 > 10 的產品 的廠商。
SELECT vend_id, COUNT(*) AS high_price_count
FROM products
WHERE prod_price > 10
GROUP BY vend_id
HAVING COUNT(*) >= 2;
執行順序:WHERE 先過濾行 → GROUP BY 分組 → 聚合計算 → HAVING 過濾組。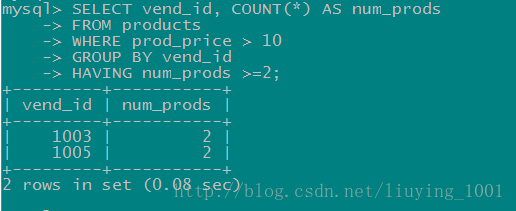
SELECT vend_id, prod_price, COUNT(*)
FROM products
GROUP BY vend_id, prod_price;
按廠商+價格雙維度分組,每組統計該價格下的產品數。
SELECT 列表中非聚合列必須出現在 GROUP BY 中(MySQL 5.7+ 默認 ONLY_FULL_GROUP_BY 模式嚴格執行)。WHERE 過濾的盡量不用 HAVING,WHERE 可利用索引減少參與分組的行數。