海量資料優化兩大路徑:
分區技術:邏輯上單表,物理上多檔案,應用零改造,兼具管理彈性與查詢效能。
| 類型 | 核心邏輯 | 典型場景 |
|---|---|---|
| RANGE | 連續區間 VALUES LESS THAN | 時間序列、數值範圍 |
| LIST | 離散值集合 VALUES IN | 地區、狀態、類別、性別 |
| HASH | 使用者運算式取模 | 均勻分佈、無明確業務邊界 |
| KEY | MySQL 內部哈希函數 | 非整數鍵、不想寫運算式 |
SHOW TABLES 僅見一張。.ibd(InnoDB)或 .MYD/.MYI(MyISAM)。InnoDB 預設共享表空間
ibdata1無法真正分區,必須啟用innodb_file_per_table = 1並重啟,新建表才會產生獨立.ibd。
[mysqld]
innodb_file_per_table = 1
innodb_data_home_dir = /data/mysql/
innodb_data_file_path = ibdata1:10M:autoextend
innodb_log_group_home_dir = /data/mysql/
SHOW ENGINES;              -- 確認 partitioning 支援
SHOW PLUGINS;              -- partition 插件 ACTIVE
SHOW CREATE TABLE tbl;     -- 查看分區定義
SHOW INDEX FROM tbl;       -- 索引分區資訊
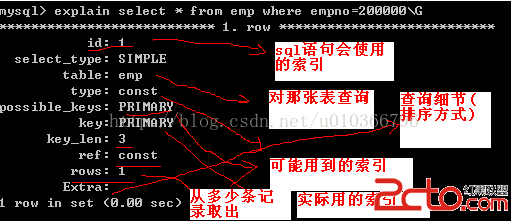
EXPLAIN PARTITIONS SELECT ... -- 驗證 Partition Pruning
DELIMITER //
CREATE PROCEDURE batch_insert()
BEGIN
    DECLARE i INT DEFAULT 1;
    WHILE i < 100000 DO
        INSERT INTO t_hash VALUES (i);
        SET i = i + 1;
    END WHILE;
END//
DELIMITER ;

CALL batch_insert();