慢查詢優化不靠猜,靠 EXPLAIN 看執行計劃。本文記錄兩個真實優化案例:一條 ORDER BY 因索引選擇錯誤導致 Using temporary; Using filesort,通過 USE INDEX 強制走正確索引,耗時從 1.5s 降至 0.015s(100 倍);一條一對一 JOIN 多餘 DISTINCT 導致臨時表,去除後提升 10 倍。並總結優化通用方法論。
SELECT * FROM channel
WHERE status = 1
ORDER BY zj_lastupdate DESC
LIMIT 20;
表 channel 有多個聯合索引,zj_lastupdate 也有單列索引。
id: 1
table: channel
type: ref
possible_keys: idx_status, idx_zj_lastupdate, idx_status_type...
key: idx_status          -- 優化器選了 status 索引
key_len: 2
ref: const
rows: 50000
Extra: Using where; Using temporary; Using filesort  -- 關鍵紅旗
優化器選擇 idx_status 過濾後需再排序,觸發臨時表+文件排序。
SELECT * FROM channel USE INDEX (idx_zj_lastupdate)
WHERE status = 1
ORDER BY zj_lastupdate DESC
LIMIT 20;key: idx_zj_lastupdate
Extra: Using where -- 無 temporary、filesortSELECT DISTINCT movie_id AS id, ...
FROM movie m
JOIN movie_detail d ON m.id = d.movie_id
WHERE ...;table: m
type: ALL
Extra: Using temporary -- DISTINCT 強制去重產生臨時表movie 主鍵 id,movie_detail 主鍵 movie_id,嚴格一對一DISTINCT 純屬畫蛇添足SELECT movie_id AS id, ...
FROM movie m
JOIN movie_detail d ON m.id = d.movie_id
WHERE ...;type、key、rows、ExtraUSE INDEX/FORCE INDEXUsing indexANALYZE TABLE,防止優化器誤判| 維度 | 手段 | 適用場景 |
|---|---|---|
| 查詢語句 | 改寫 SQL、去冗餘、拆分大查詢 | 邏輯複雜、冗餘列、臨時表 |
| 索引 | 聯合索引最左前綴、覆蓋索引、下推 (ICP) | WHERE/ORDER BY/GROUP BY 列 |
| 表結構 | 垂直拆分、水平分片、冗余列避免 JOIN | 大寬表、高頻熱點列 |
| 字段類型 | 優先數值、定長、NOT NULL、最小長度 | 索引列、連接鍵 |
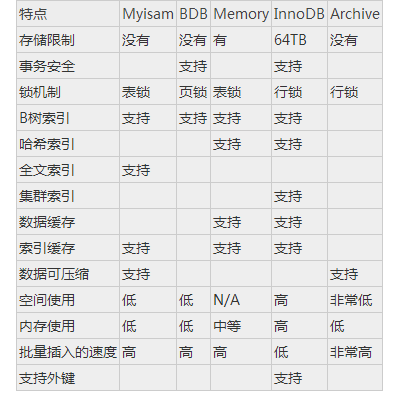
| 存儲引擎 | InnoDB(事務、行鎖)、MyISAM(全文、只讀) | 業務屬性決定 |
| 緩存 | Query Cache(5.7)、Redis、應用級緩存 | 讀多寫少、數據允許秒級延遲 |
| 系統 | innodb_buffer_pool_size、innodb_flush_log_at_trx_commit、文件系統 noatime | 硬件資源充分利用 |
| 磁盤 | SSD、RAID10、分離 redo log / data / binlog | 高 IOPS 場景 |
pt-query-digest:慢查詢日志分析 Top Nsys.schema_* 視圖:表統計、索引使用率、冗余索引檢測EXPLAIN ANALYZE (8.0.18+):實際執行耗時、循環次數Optimizer Trace:優化器決策細節