MySQL 索引背後的資料結構與演算法原理深度解析
「程式 = 資料結構 + 演算法」,要真正掌握 MySQL 索引優化,必須從底層資料結構切入。本文聚焦 B+Tree 索引,結合 MyISAM 與 InnoDB 存儲引擎,從原理到實戰全景剖析。
一、索引的本質:高效獲取數據的資料結構
MySQL 官方定義:索引是幫助高效獲取數據的資料結構。本質上,索引是滿足特定查找演算法(如二分查找)的資料結構,透過指針引用實際數據。
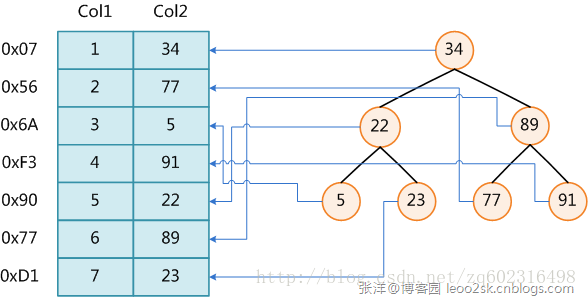
雖然二叉查找樹可實現索引,但資料庫系統幾乎不使用,原因在於磁盤 I/O 特性。
二、B-Tree 與 B+Tree:索引的主流選擇
B-Tree 定義
- 度 d、高度 h
- 非葉節點:n-1 個 key、n 個指針 (d ≤ n ≤ 2d)
- 葉節點:1~2d-1 個 key、2d 個指針(均為 null)
- 所有葉節點深度相同,key 非遞減排列
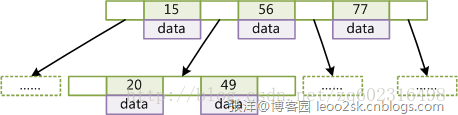
查找複雜度 O(logdN),極高效。
B+Tree 改進點
- 節點指針上限 2d(而非 2d+1)
- 內節點僅存 key,不存 data;葉節點不存指針,存完整 data
- 葉節點透過鏈表指針連接,支援高效範圍查詢
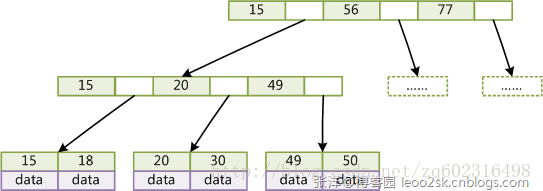
三、為什麼選 B+Tree?結合磁盤存取原理
磁盤 I/O 為核心瓶頸
索引存於磁盤,查找過程產生磁盤 I/O。評價索引優劣的關鍵指標是磁盤 I/O 次數的漸進複雜度。
主存 vs 磁盤存取
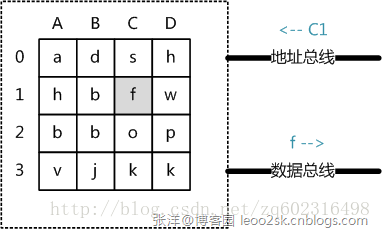
- 主存(RAM):隨機存取,時間僅與存取次數線性相關,無機械延遲。
- 磁盤:機械運動(尋道時間 + 旋轉延遲),速度慢數個數量級。
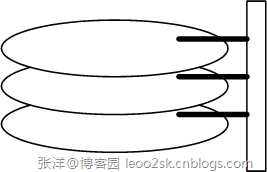
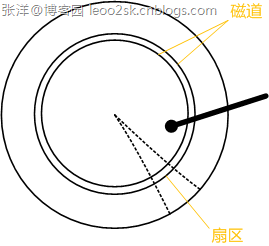
局部性原理與預讀
磁盤順序讀取極快,作業系統以「頁」(通常 4KB)為單位預讀。資料庫將一個 B+Tree 節點大小設為一頁,使每次節點載入僅需 1 次 I/O。
B+Tree 效能分析
- 樹高 h 通常 ≤ 3(出度 d > 100),最多 h-1 次 I/O(根節點常駐內存)。
- 紅黑樹等結構高度大,邏輯鄰近節點物理離散,無法利用局部性,I/O 效率低。
- B+Tree 內節點無 data 域,出度更大,樹高更低,更適合外存索引。
四、MySQL 索引實現:MyISAM vs InnoDB
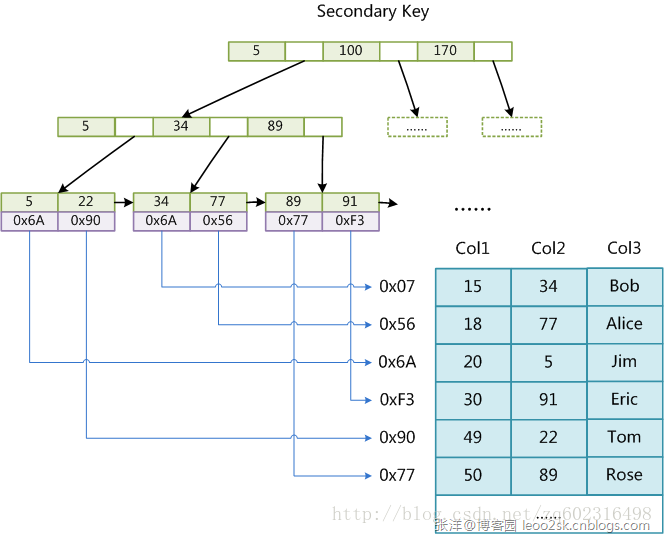
MyISAM:非聚集索引
- 索引文件與數據文件分離
- 主索引與輔助索引結構相同,葉節點存數據記錄地址
- 主索引 key 唯一,輔助索引 key 可重複
InnoDB:聚集索引
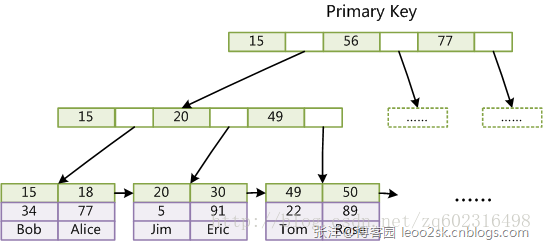
- 數據文件本身就是主索引(B+Tree),葉節點存完整數據行
- 表必須有主鍵(無則隱式生成 6 字節長整型)
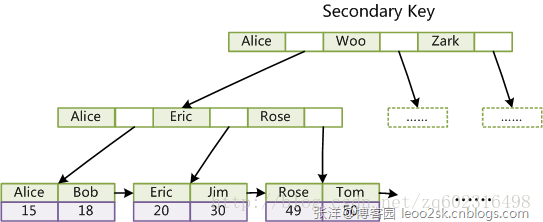
- 輔助索引葉節點存主鍵值而非地址
- 輔助索引查找需「回表」:先查輔助索引得主鍵,再查主索引得數據
五、高效能索引策略與優化
最左前綴原理
聯合索引 <a,b,c> 僅當查詢條件包含最左連續列時生效。
- 全列匹配:
WHERE a=1 AND b=2 AND c=3 ✅
- 最左前綴:
WHERE a=1、WHERE a=1 AND b=2 ✅
- 中斷列:
WHERE a=1 AND c=3 僅用 a ❌
- 無首列:
WHERE b=2 索引失效 ❌
- 範圍列:
WHERE a>1 AND b=2 僅用 a,b 失效
- 函數/運算式:
WHERE LEFT(b,3)='abc' 索引失效 ❌
優化技巧:「填坑」用 IN 列舉中斷列值,或建輔助索引。
索引選擇性與前綴索引
選擇性 = 不重複值 / 總行數。選擇性低(如性別、狀態)不宜建索引。
前綴索引:用列前 N 字符建索引,平衡選擇性與索引大小。
缺點:不可用於 ORDER BY、GROUP BY、覆蓋索引。
InnoDB 主鍵選擇:自增最佳
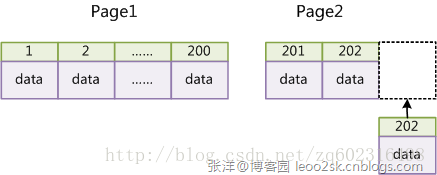
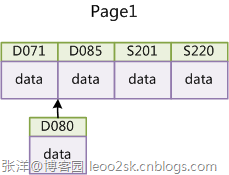
- 自增主鍵:順序寫入,頁分裂少,索引緊湊,效能高。
- 非自增(UUID、身份證):隨機插入,頻繁頁分裂、碎片,效能差。
後記
索引優化是理論與實踐結合的技術活。理解 B+Tree、聚集/非聚集索引、最左前綴等核心原理,才能在複雜場景下做出正確判斷。本文未涵蓋覆蓋索引、排序優化、Hash/全文索引等進階主題,留待後續補充。