主從復制是 MySQL 高可用架構的基石,讀寫分離是擴展讀性能的核心手段。本文系統闡述原理架構、實施方案、中間件選型及演進路線圖。
┌─────────────┐     Binlog Dump      ┌─────────────┐
│   Master    │ ◄────────────────── │   Slave     │
│  (Writer)   │   Replication       │  (Reader)   │
└─────────────┘                     └─────────────┘
      │                                    │
      │ Write (INSERT/UPDATE/DELETE)       │ Read (SELECT)
      ▼                                    ▼
┌─────────────┐                     ┌─────────────┐
│ Application │                     │ Application │
└─────────────┘                     └─────────────┘
binlog_format)| 方案 | 實現層 | 優點 | 缺點 | 代表產品 |
|---|---|---|---|---|
| 應用代碼路由 | Application | 無額外組件、靈活控制 | 侵入業務碼、維護成本高 | 手動 DataSource 切換 |
| AOP/注解攔截 | Framework | 低侵入、統一管理 | 框架綁定、複雜事務難處理 | Spring @Transactional + AbstractRoutingDataSource |
| 中間件代理 | Network | 透明無侵入、統一治理 | 單點風險、性能開銷 | MyCat, ProxySQL, ShardingSphere-Proxy |
| 驅動層路由 | Driver | 應用無感、標準化 | 驅動版本綁定、功能受限 | MySQL Connector/J ReplicationDriver |
@Configuration
public class DataSourceConfig {

    @Bean
    @Primary
    public DataSource routingDataSource() {
        Map targetDataSources = new HashMap<>();
        targetDataSources.put("master", masterDataSource());
        targetDataSources.put("slave", slaveDataSource());

        RoutingDataSource proxy = new RoutingDataSource();
        proxy.setTargetDataSources(targetDataSources);
        proxy.setDefaultTargetDataSource(masterDataSource());
        return proxy;
    }

    public class RoutingDataSource extends AbstractRoutingDataSource {
        @Override
        protected Object determineCurrentLookupKey() {
            return DataSourceContextHolder.getDataSourceType();
        }
    }
}

public class DataSourceContextHolder {
    private static final ThreadLocal context = new ThreadLocal<>();

    public static void setMaster() { context.set("master"); }
    public static void setSlave() { context.set("slave"); }
    public static String getDataSourceType() { return context.get() != null ? context.get() : "master"; }
    public static void clear() { context.remove(); }
}

@Aspect
@Component
public class DataSourceAspect {
    @Before("execution(* com.example.service..*.save*(..)) || " +
            "execution(* com.example.service..*.update*(..)) || " +
            "execution(* com.example.service..*.delete*(..))")
    public void setMaster() { DataSourceContextHolder.setMaster(); }

    @Before("execution(* com.example.service..*.find*(..)) || " +
            "execution(* com.example.service..*.get*(..)) || " +
            "execution(* com.example.service..*.query*(..))")
    public void setSlave() { DataSourceContextHolder.setSlave(); }

    @After("execution(* com.example.service..*(..))")
    public void clear() { DataSourceContextHolder.clear(); }
}
階段 1:單主單從 + 讀寫分離
┌─────────┐     ┌─────────┐
│ Master  │────►│ Slave   │
└─────────┘     └─────────┘
   │ Write          │ Read

階段 2:雙主互備 (MHA/Orchestrator)
┌─────────┐     ┌─────────┐
│ Master1 │◄───►│ Master2 │
└─────────┘     └─────────┘
   │                 │
   ▼                 ▼
┌─────────┐     ┌─────────┐
│ Slave1  │     │ Slave2  │
└─────────┘     └─────────┘

階段 3:集群化 (InnoDB Cluster / Galera / Group Replication)
┌─────────────────────────────────────┐
│        Primary (R/W)                │
├─────────────────────────────────────┤
│  Secondary (R/O)  │  Secondary (R/O) │
└─────────────────────────────────────┘
自動故障切換、多主寫入、強一致性
| 挑戰 | 影響 | 解決方案 |
|---|---|---|
| 主從延遲 | 讀到舊數據 | 關鍵業務強制走主、半同步複製、GTID 監控延遲 |
| 數據不一致 | 業務邏輯錯誤 | pt-table-checksum 定期校驗、Row 格式 Binlog |
| 主庫故障切換 | 服務不可用 | MHA/Orchestrator 自動故障轉移、VIP 漂移 |
| 事務一致性 | 跨庫事務失敗 | 避免跨主從事務、分佈式事務 (Seata)、最終一致性補償 |
| 從庫故障 | 讀性能下降 | 多從庫負載均衡、健康檢查自動剔除 |
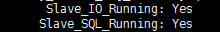
Slave_IO_Running=Yes, Slave_SQL_Running=Yes, Seconds_Behind_Master=0Seconds_Behind_Master > 300 告警,結合 pt-heartbeat 精準測量@Master 註解或 forceMaster() API 供關鍵業務調用主從復制與讀寫分離不是銀彈,而是架構演進的必經階段。隨著業務增長,最終將向分佈式數據庫(TiDB、PolarDB、InnoDB Cluster)演進,實現真正的水平擴展與強一致高可用。