首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> MySQL 資料庫 >> MySQL 綜合教學

一致性 Hash 與 Solr 在海量數據分布式搜索引擎中的實踐

     編輯:MySQL 綜合教學

一致性 Hash 與 Solr 在海量數據分布式搜索引擎中的實踐

Solr 作為企業級搜索服務器,提供類 Web Service 的 HTTP API。在資源受限的創業初期,利用開源技術(MySQL、Nginx 等)配合廉價服務器橫向擴展,即可支撐千萬級訪問量。本文聚焦數據分流路由的核心問題:如何在節點變動時最小化數據遷移,並介紹自研 Solr 分布式架構中一致性 Hash 的應用。

一、 橫向擴展與路由難題

面對單機容量瓶頸,橫向擴展(Scale-out) 是主流選擇:採購多台廉價機器分攤負載。假設 3 台機器各存 200 萬數據,共 600 萬。路由演算法需均衡分發請求。

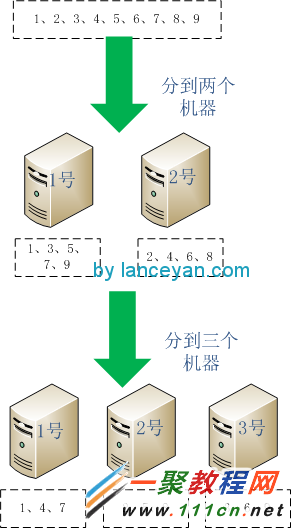
簡單取模(id % N)在節點數變更時會導致大規模數據遷移。例如 9 條數據從 2 節點擴展到 3 節點,幾乎所有數據都需重新分發。數據量達億級/TB 級時,遷移耗時數小時甚至數天,且源庫負載飆升,極不現實。
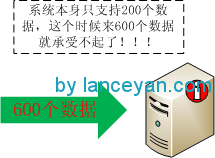
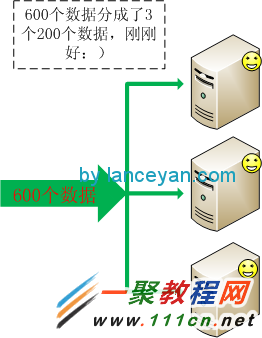
橫向擴展示意圖
取模路由遷移示意
節點擴容導致全量遷移

二、 一致性 Hash:最小化遷移的核心演算法

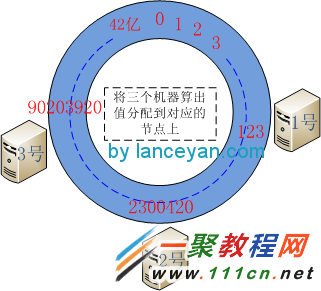
一致性 Hash 將「機器節點」與「數據鍵」映射至同一個 2^32 的虛擬環形空間。步驟如下:
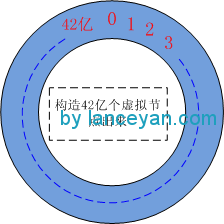
  1. 構造虛擬環:2^32(約 42 億)個節點,足夠支撐極大規模集群。
  2. 節點入環:對機器 IP 或 Hostname 取 Hash,對 2^32 取模,定位於環上。
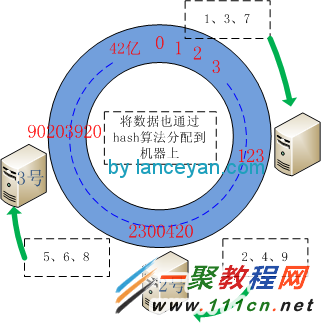
  3. 數據入環:對數據 Key 同樣計算 Hash 定位。
  4. 順時針尋找:數據從其位置順時針查找最近的節點,歸屬該節點。若超過 2^32 未找到,回環至第一個節點。
一致性 Hash 環結構
節點映射到環
數據映射與歸屬

擴容/縮容影響分析

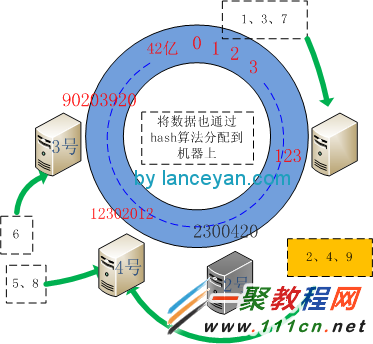
新增節點 4(Hash=12302012),僅影響其逆時針區間內的數據(原屬節點 3 的 5、8 遷移至節點 4),其餘數據完全不動。同理,節點下線僅影響其順時針區間數據遷移至下一節點。
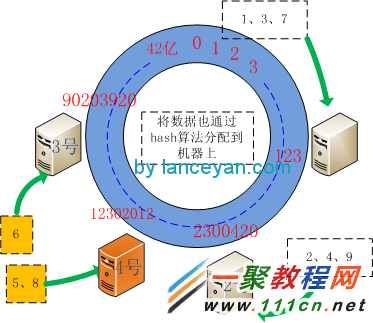
新增節點遷移範圍
節點下線遷移範圍

虛擬節點解決傾斜

物理節點較少時,數據分布可能不均。引入虛擬節點:每台物理機映射多個虛擬節點(如 1a,1b,1c),實際仍路由至物理機 1,但環上分布更均勻。
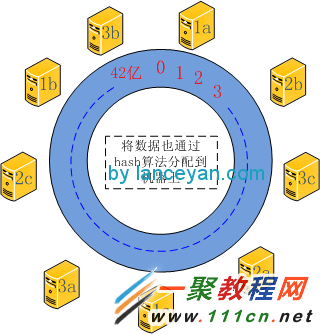
虛擬節點機制

三、 自研 Solr 分布式架構:摒棄 SolrCloud,採用一致性 Hash 自管路由

實測 SolrCloud (ZooKeeper 協調) 寫入 20 條數據耗時數十秒,性能不達標。決定自行 Hack Solr,移除 ZooKeeper,採用一致性 Hash 客戶端路由。
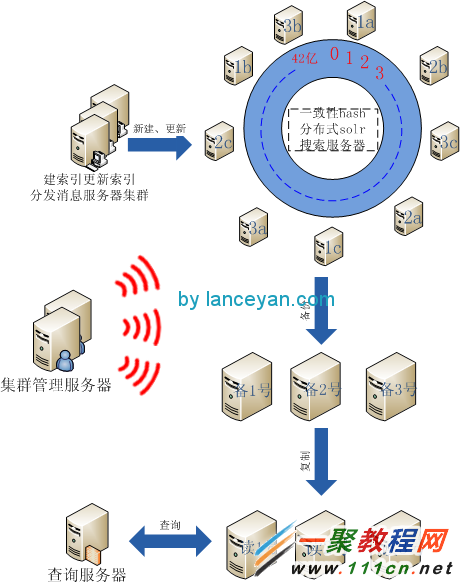
自研 Solr 分布式架構圖

架構角色與職責

  • 建立/更新服務器:維護機器位置映射,根據 Key 路由寫入/更新索引,需保證高效可靠。
  • 備份服務器:熱備建立服務器,故障時快速切換恢復。
  • 讀服務器:專職查詢,實現讀寫分離,避免寫入鎖影響搜索性能。
  • 集群管理服務器:監控節點狀態、告警、元數據管理。

業務擴展策略

隨業務增長,按數據類型(用戶、微博等)劃分獨立集群,每類集群復用上述架構,滿足通用分布式搜索性能需求。

  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved