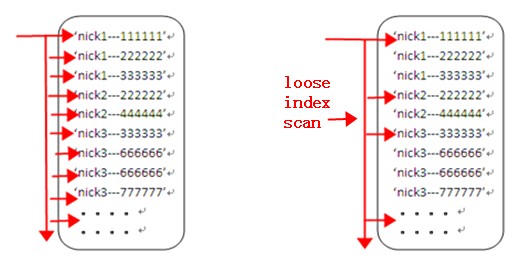
SELECT COUNT(DISTINCT nick) FROM user_access_xx_xx;nick 有索引type=index(全索引掃描)索引按 (nick, other_column) 升序排列。原查詢從第一個 nick 掃到最後,中間大量重複值逐行讀取。
Oracle 有 Loose Index Scan**(跳躍掃描)**,直接跳過重複值;MySQL 5.1 不支援,需手工模擬。
SELECT COUNT(*) FROM (
    SELECT DISTINCT nick FROM user_access
) t;| 指標 | 原始寫法 | 優化寫法 |
|---|---|---|
| 執行時間 | 52.78 秒 | 5.81 秒(快 9 倍) |
| Extra | Using index | Using index for group-by** |
| 掃描行數 | 19,546,123 | 2,124,695 |
DISTINCT 內部轉為 GROUP BYSELECT DISTINCT nick 觸發 Using index for group-by:優化器利用索引分組,**每個 nick 僅掃描一次**COUNT(*) 僅統計結果集行數,極快DISTINCT、該欄位有索引、資料量大、重複度高DISTINCT a,b、無索引、資料量小Loose Index Scan,但此技巧在舊版本依然有效💡 一句話心法:大表 COUNT(DISTINCT col) 慢時,改成 SELECT COUNT(*) FROM (SELECT DISTINCT col FROM tbl) t 利用 Using index for group-by 跳躍掃描。