資料庫設計階段常面臨兩大難題:字段長度如何設定才合適?是否必須嚴格遵循第三範式(3NF)?本文從資料類型優化、垂直/水平拆分、逆範式化三個維度,給出落地建議。
PROCEDURE ANALYSE() 獲取建議MySQL 內建此函數可分析表中列的實際數據分佈,並給出最優類型建議。
-- 基本語法
SELECT * FROM table_name PROCEDURE ANALYSE();
-- 限制 enum 建議的閾值
SELECT * FROM table_name PROCEDURE ANALYSE(16, 255);
element_num:超過此不同值數量不建議用 ENUMmax_memory:超過此位元組數不建議用 ENUMSELECT * FROM c PROCEDURE ANALYSE(16, 255);
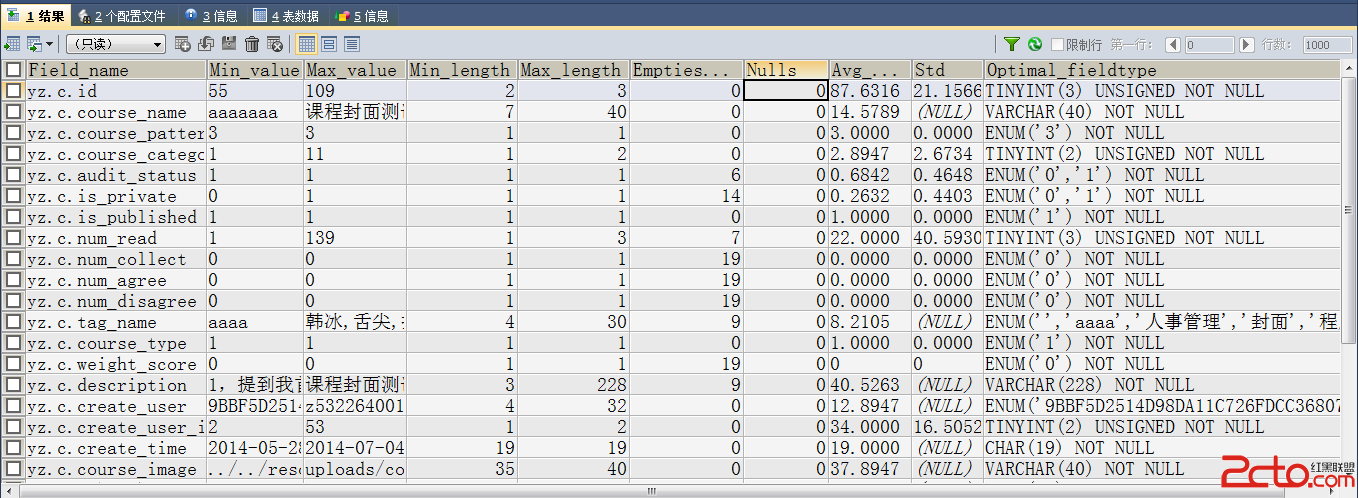
關鍵欄位:field_name(列名)、optimal_fieldtype(建議類型)。
將主鍵與高頻列放入主表,低頻/大字段(如 TEXT、BLOB)移至擴展表,透過主鍵關聯。
優點: 行長度變短 → 單頁存更多行 → 減少 I/O;缺點: 需管理冗餘主鍵,全字段查詢需 JOIN。
適用場景: 表寬、部分列極少被讀取(如用戶基本資料 vs. 詳細偏好設定)。
按規則(範圍、Hash、時間)將行數據分散到多張結構相同的表或分區中。
適用場景:
在高並發讀場景下,適度引入冗餘列、減少 JOIN,以空間換時間。
| 優勢 | 代價 |
|---|---|
| 降低 JOIN 次數與關聯索引 | 數據冗餘,寫入需同步多處 |
| 減少表數量,查詢更簡單 | 可能破壞數據完整性(需應用層/觸發器保證) |
| 顯著提升讀取速度 | 更新/刪除效能下降 |
核心原則: 讀多寫少、容忍最終一致性的業務(如商品詳情頁、報表快照)優先考慮;核心交易、強一致性場景堅持範式化。
PROCEDURE ANALYSE() 掃描現有表,收斂過長字段。