MySQL(關係型)與 MongoDB(文檔型/NoSQL)代表兩種數據模型範式。本文提供核心操作對照表、關鍵差異解析及選型建議,助你快速完成技術棧切換或混合架構設計。
| MySQL | MongoDB | 說明 |
|---|---|---|
| database | database | 命名空間概念一致 |
| table | collection | 結構化 vs 無模式 |
| row | document | 元組 vs BSON 文檔 |
| column | field | 列 vs 字段 |
| index | index | B+樹 vs B樹(支援地理/文本索引) |
| join | $lookup / 嵌入文檔 | 關聯 vs 反範式化 |
| transaction | transaction (4.0+) | ACID 支援度趨同 |
| primary key | _id (ObjectId) | 自增 ID vs 12 字節唯一標識 |
| 操作 | MySQL (SQL) | MongoDB (MQL) |
|---|---|---|
| 插入單條 | INSERT INTO user(name,age) VALUES('Tom',20); | db.user.insert({name:'Tom',age:20}) |
| 插入多條 | INSERT INTO user VALUES(...),(...); | db.user.insert([{...},{...}]) |
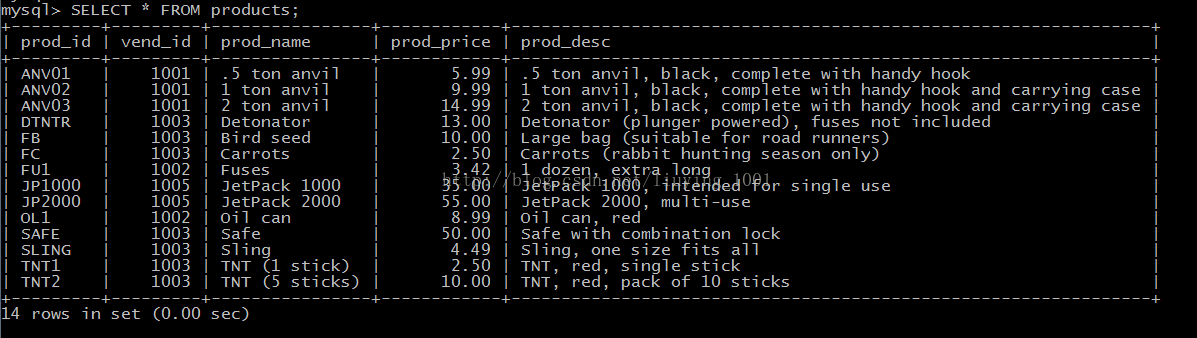
| 查詢所有 | SELECT * FROM user; | db.user.find() |
| 條件查詢 | SELECT * FROM user WHERE age>18; | db.user.find({age:{$gt:18}}) |
| 更新 | UPDATE user SET age=21 WHERE name='Tom'; | db.user.update({name:'Tom'},{$set:{age:21}}) |
| 刪除 | DELETE FROM user WHERE name='Tom'; | db.user.remove({name:'Tom'}) |
| 聚合統計 | SELECT COUNT(*) FROM user; | db.user.count() |
| 分組聚合 | SELECT dept,AVG(sal) FROM emp GROUP BY dept; | db.emp.aggregate([{$group:{_id:'$dept',avg:{$avg:'$sal'}}})) |
// 正確:單個文檔對象
db.user.insert({id:1, name:'steve', sex:'male'})

// 錯誤:多個獨立對象(視為多文檔批量插入,但語法錯誤)
db.user.insert({id:2}, {name:'bear'}, {sex:'female'})
| 維度 | 選 MySQL | 選 MongoDB |
|---|---|---|
| 數據結構 | 高度結構化、Schema 穩定 | 半結構化、Schema 頻繁變更 |
| 事務需求 | 強一致、多表事務 | 單文檔事務為主(4.0+ 支援多文檔) |
| 查詢模式 | 複雜關聯、多維分析 | 鍵值/文檔訪問、地理空間、全文搜索 |
| 擴展性 | 垂直擴展、讀寫分離 | 原生分片、水平擴展 |
| 數據量 | TB 級單表性能下降明顯 | 百 TB 級分片集群線性擴展 |
| 運維成本 | 成熟工具鏈、DBA 易招聘 | 運維複雜度高、專業人才稀缺 |
find() 返回游標,大結果集必須分批 batchSize() 或流式處理--auth、配置副本集、啟用 WiredTiger 壓縮「沒有最好的數據庫,只有最合適的場景」。理解兩種範式的本質差異,按業務特性拆分存儲,才是現代架構的正解。