分區將大表物理拆分為多個較小片段,對應用透明。本文以 Hash 分區為例,演示創建、管理(增減分區)、與非分區表查詢性能對比。
CREATE TABLE t_hash (
  id INT UNSIGNED,
  name CHAR(1)
) ENGINE=MyISAM CHARSET=utf8
PARTITION BY HASH(id)
PARTITIONS 5;
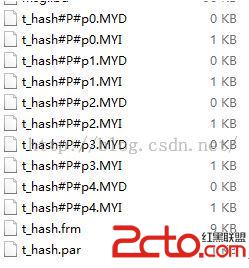
物理文件:t_hash#P#p0.MYD ~ p4.MYD(5 個分區文件)
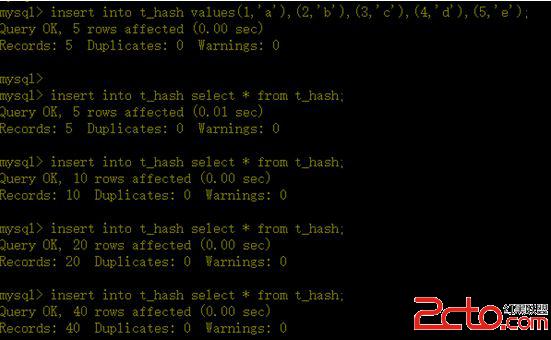
INSERT INTO t_hash VALUES (1,'a'),(2,'b'),(3,'c'),(4,'d'),(5,'e'),(6,'f'),(7,'g'),(8,'h'),(9,'i'),(10,'j');
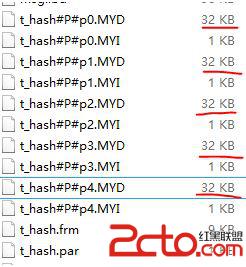
Hash 分區特性:數據均勻分布,各分區文件大小近似。
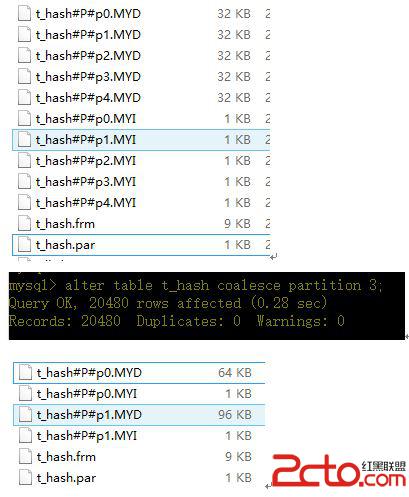
ALTER TABLE t_hash COALESCE PARTITION 3; -- 5 → 2
數據自動重分佈到剩餘分區。
ALTER TABLE t_hash COALESCE PARTITION 1; -- 2 → 1
不可再減,至少保留 1 個分區。
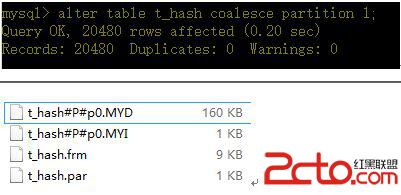
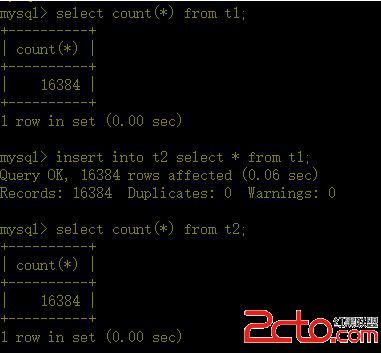
-- 非分區
CREATE TABLE t2 (id INT UNSIGNED, name CHAR(1)) ENGINE=MyISAM CHARSET=utf8;
-- 分區
CREATE TABLE t1 (id INT UNSIGNED, name CHAR(1)) ENGINE=MyISAM CHARSET=utf8 PARTITION BY HASH(id) PARTITIONS 4;
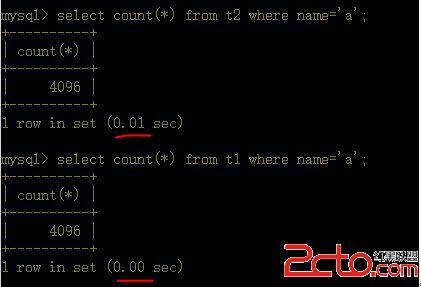
SELECT * FROM t1 WHERE name='a';
SELECT * FROM t2 WHERE name='a';
結果:分區表耗時 小於 非分區表(分區裁剪生效,僅掃描相關分區)。
| 類型 | 適用場景 | 優點 | 缺點 | 優先級 |
|---|---|---|---|---|
| RANGE | 時間序列、遞增 ID、明顯區間 | 支援分區裁剪、易歸檔歷史分區 | 分區數固定、熱點分區寫入壓力大 | ★★★★★ |
| LIST | 枚舉值(地區、狀態、類別) | 精確映射、支援分區裁剪 | 值不在列表數據丟失、分區數固定 | ★★★★☆ |
| HASH | 均勻分布、無明顯業務鍵 | 數據均勻、擴容縮容平滑 | 線性 Hash 分布不均、無業務語義 | ★★★☆☆ |
| KEY | 非整數列(字符串、日期) | 支援任意列、MySQL 內置 Hash 函數 | 函數複雜 (MD5/SHA)、性能略低 | ★★★☆☆ |
ANALYZE TABLE 更新分區統計信息ALTER TABLE ... DROP PARTITION 秒級清理歷史數據分區是「物理拆分、邏輯透明」的大表治理利器,選對分區類型與鍵,查詢性能可獲數量級提升。