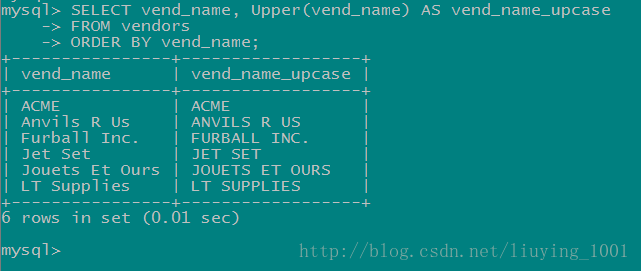
字符集決定「如何存儲」,校對規則決定「如何比較」。配置不當會導致亂碼、索引失效、排序錯誤、數據截斷。本文系統梳理編碼原理、MySQL 多層級字符集設置、校對規則選型、實戰避坑指南。
| 概念 | 定義 | 示例 |
|---|---|---|
| 字符集 | 字符與編碼的映射集合 | utf8mb4: '中' → 0xE4B8AD (3 字節) |
| 校對規則 | 同一字符集內字符的比較/排序規則 | utf8mb4_general_ci: 'a' = 'A'; utf8mb4_bin: 'a' != 'A' |
| 編碼 | 字符 → 二進制的具體算法 | UTF-8: 1-4 字節變長編碼 |
| 字符集 | 最大字節/字符 | 支持範圍 | MySQL 版本備註 |
|---|---|---|---|
| latin1 | 1 | 西歐語系 | 早期默認,不支持中文 |
| gbk | 2 | 中文簡體+繁體 | 國內早期常用 |
| utf8 | 3 | BMP 平面 (U+0000-U+FFFF) | MySQL 獨有別名,實為 utf8mb3,**不支持 Emoji/生僻字** |
| utf8mb4 | 4 | 完整 Unicode (U+0000-U+10FFFF) | 5.5.3+ 推薦默認,支持 Emoji、生僻字 |
結論:新項目強制使用 utf8mb4,避開 utf8 陷阱。
Server (服務器級)
  └─ Database (數據庫級)
       └─ Table (表級)
            └─ Column (列級)
└─ Connection (連接級:client/server/results)my.cnf[mysqld]
character-set-server = utf8mb4
collation-server = utf8mb4_general_ci # 或 utf8mb4_unicode_ci
init_connect = 'SET NAMES utf8mb4' # 非超級用戶連接自動執行CREATE DATABASE app_db CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci;
ALTER DATABASE app_db CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci;CREATE TABLE t1 (c1 VARCHAR(50)) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci;
ALTER TABLE t1 CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci; -- 轉換現有數據CREATE TABLE t2 (
c1 VARCHAR(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_bin, -- 區分大小寫
c2 TEXT CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci
);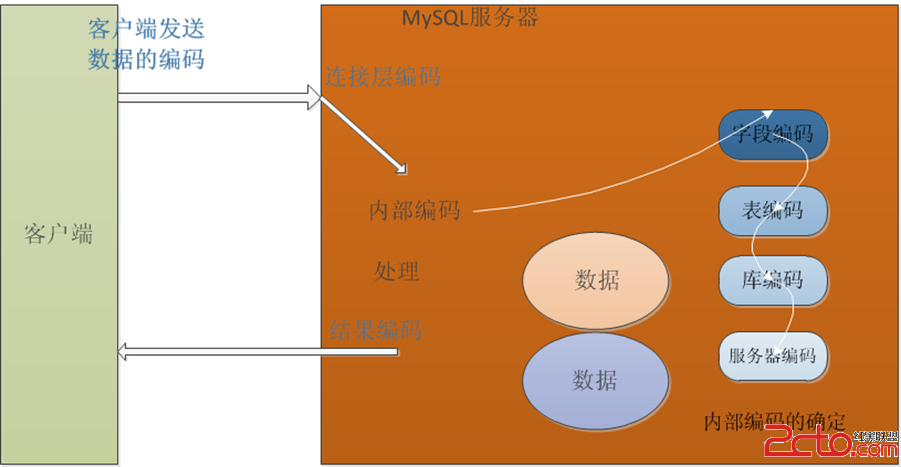
-- 客戶端發送/接收編碼
SET NAMES utf8mb4;  -- 等價於下面三條
SET character_set_client = utf8mb4;
SET character_set_results = utf8mb4;
SET character_set_connection = utf8mb4;

-- 服務器內部操作編碼
character_set_database, character_set_server, character_set_system (只讀 utf8)驗證命令:SHOW VARIABLES LIKE 'character_set_%'; SHOW VARIABLES LIKE 'collation_%';
命名規則:charset_language_ci/cs/bin
_ci:Case Insensitive(不區分大小寫),如 utf8mb4_general_ci、utf8mb4_unicode_ci、gbk_chinese_ci。_cs:Case Sensitive(區分大小寫),如 utf8mb4_cs(8.0+)。_bin:Binary(按字節碼值比較),如 utf8mb4_bin、gbk_bin,性能最快、最嚴格。CREATE TABLE t_ci (name VARCHAR(10)) CHARACTER SET gbk COLLATE gbk_chinese_ci;
CREATE TABLE t_bin (name VARCHAR(10)) CHARACTER SET gbk COLLATE gbk_bin;
INSERT INTO t_ci VALUES ('a'), ('B'), ('c');
INSERT INTO t_bin VALUES ('a'), ('B'), ('c');
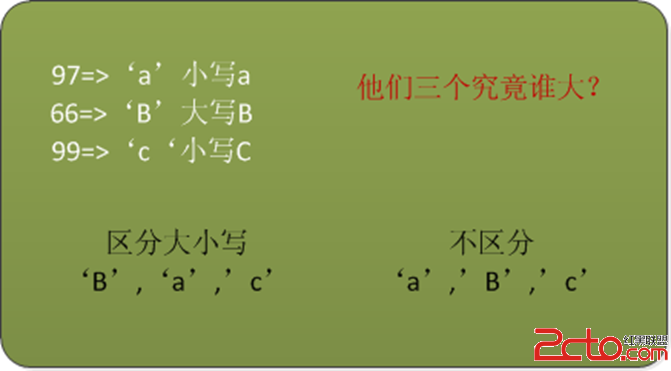
SELECT * FROM t_ci ORDER BY name; -- a, B, c (不區分大小寫,按拼音/字典序)
SELECT * FROM t_bin ORDER BY name; -- B, a, c (按字節碼:B=0x42, a=0x61)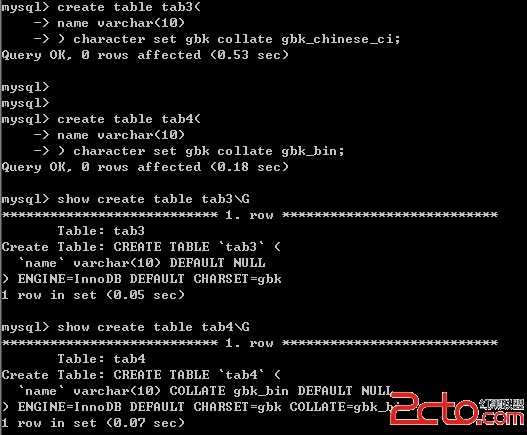
| 坑點 | 現象 | 根因 | 解決 |
|---|---|---|---|
| Emoji 存儲報錯/變 ? | Incorrect string value / 存入 ???? | 字符集為 utf8 (utf8mb3) 不支持 4 字節字符 | 全鏈路 utf8mb4:Server/DB/Table/Column/Connection/JDBC URL |
| 大小寫敏感不一致 | WHERE name='abc' 匹配到 'ABC' | 校對規則 _ci 不區分大小寫 | 列級指定 _bin 或 _cs;或 WHERE BINARY name='abc' |
| 排序順序不符預期 | 中文排序亂序、大小寫混排 | 校對規則語言權重差異 | 選用 unicode_ci(UCA 標準)或 bin(字節序) |
| JOIN/關聯查詢慢/不走索引 | 關聯列字符集/校對規則不一致 | 隱式轉換導致索引失效 | 統一關聯列字符集與校對規則,或顯式 CAST |
| 數據遷移亂碼 | 導出導入後中文變亂碼 | 導出/導入端字符集聲明不一致 | mysqldump --default-character-set=utf8mb4;導入前 SET NAMES utf8mb4 |
| 索引長度超限 | Specified key was too long; max key length is 767 bytes | utf8mb4 字符佔 4 字節,VARCHAR(255) 索引超 767 | 縮短列長度、用前綴索引、升級 5.7+ (InnoDB 3072 bytes) 或啟用 innodb_large_prefix |
my.cnf 設定 character-set-server=utf8mb4,重啟實例。ALTER DATABASE db_name CHARACTER SET = utf8mb4 COLLATE = utf8mb4_general_ci;ALTER TABLE tbl_name CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci;ALTER TABLE tbl_name MODIFY col_name VARCHAR(100) CHARACTER SET utf8mb4 COLLATE utf8mb4_bin;SHOW CREATE TABLE tbl_name\G 確認 CHARSET=utf8mb4、COLLATE=...;抽樣查詢中文/Emoji 讀寫。?characterEncoding=utf8mb4&connectionCollation=utf8mb4_general_ci,Python charset='utf8mb4',Go DSN charset=utf8mb4。SET NAMES utf8mb4,納入連接池初始化 SQL。character_set_client/results/connection 變量,防止會話級污染。