首頁
編程語言
C語言|JAVA編程
Python編程
網頁編程
ASP編程|PHP編程
JSP編程
數據庫
MYSQL數據庫|SqlServer數據庫
Oracle數據庫|DB2數據庫
您现在的位置: 程式碼之家 >> 數據庫知識 >  >> MySQL 資料庫 >> MySQL 綜合教學

一次 MySQL 慢查詢導致的生產故障復盤:從現象到根因的系統化排查

     編輯:MySQL 綜合教學

一次 MySQL 慢查詢導致的生產故障復盤:從現象到根因的系統化排查

慢查詢不僅拖慢單條 SQL,更可能引發連鎖反應癱瘓整個數據庫。本文復盤一起由錯誤子查詢引發的生產級故障,提煉通用排查方法論。

故障現象

  • 研發反饋:數據庫「僵死」,連接極難建立,簡單查詢耗時極長。
  • 監控顯示:CPU 使用率飆高,IO 讀寫正常,慢查詢數量激增。
  • SHOW PROCESSLIST:會話數暴增至 600+(正常 ~100),大量 Locked 狀態。

排查與處理實錄

1. 定位異常 SQL

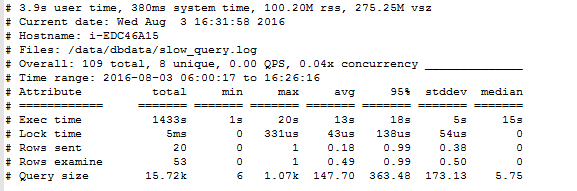
查看慢查詢日志,發現問題 SQL 集中在幾條:包含 SUM、COUNT、等值操作,且均使用子查詢。`long_query_time=3s`,實際執行卻達幾十秒。

2. 嘗試 Kill 失效

腳本批量 Kill 相關會話,但新連接湧入速度遠超 Kill 速度,`mysqld` 進程 CPU/內存持續居高不下。

3. 關鍵突破:SHOW FULL PROCESSLIST

發現頂部有幾條 SQL,Time 列高達 30000 秒(~10小時)!EXPLAIN 顯示 Using temporary、Using filesort,典型的低效執行計劃。

4. 確認根因與止血

  • 與開發核實:上午 9 點提交代碼引入該子查詢,發現問題後已註釋,但舊連接未釋放持續佔用資源。
  • 緊急 Kill 這幾條長事務會話 → 會話數瞬降至 100+ → CPU/內存驟降 → 業務恢復正常。

故障時間線對應驗證

  • 慢查詢激增曲線 ↔ 代碼部署時間 吻合
  • CPU 飆高曲線 ↔ 子查詢執行時間 吻合
  • 會話堆積曲線 ↔ 連接未釋放 吻合

結論:錯誤的子查詢(大表關聯、臨時表、文件排序)是故障罪魁禍首。

系統化排查方法論(四步法)

  1. 看監控,找異常:服務器監控 + MySQL 監控雙維度,對比同期歷史基線(昨日/前日同一時間),快速定位 CPU、IO、連接數、慢查詢等指標異常點。
  2. 查慢日志,鎖定 SQL:慢查詢日志是「現場指紋」,提取高頻/高耗時 SQL,EXPLAIN 分析執行計劃,識別 Using temporary、filesort、全表掃描等紅旗標誌。
  3. 抓大放小,先止血:優先 Kill 耗時最長、資源佔用最大的會話(大塊問題),小問題往往隨之自愈。本案中 Kill 3 條長事務即解除連接風暴。
  4. 復盤總結,固防線:建立事後分析機制,輸出事故報告。

組織與流程層面的深度反思

  • 高效溝通事半功倍:DBA 與開發建立直通溝通渠道,減少推諉內耗。
  • DBA 定期輸出 Top N SQL:參考 Oracle AWR 思路,定期推送高消耗 SQL 給開發協助優化,源頭治理。
  • 監控必須做對比:單點指標無意義,同比/環比才是異常檢測的放大鏡。

實戰技巧:批量 Kill 會話腳本

# 1. 導出全量進程
mysql -uroot -p'XXX' -e "SHOW FULL PROCESSLIST;" > /tmp/full_process.txt

# 2. 篩選目標會話 ID(如按 Info 關鍵字)
grep "bad_sql_keyword" /tmp/full_process.txt | awk '{print $1}' > /tmp/kill_ids.txt

# 3. 生成 Kill 語句並執行
mysql -uroot -p'XXX' -e "$(awk '{print "KILL " $1 ";"}' /tmp/kill_ids.txt)"

# 或純 SQL 生成(無需導出文件)
SELECT CONCAT('KILL ', id, ';') FROM information_schema.processlist WHERE info LIKE '%bad_sql_keyword%';

將上述邏輯封裝為可複用腳本,納入應急預案庫,關鍵時刻秒級止血。

  1. 上一篇文章:
  2. 下一篇文章:
Copyright © 程式碼之家 All Rights Reserved