MySQL 開發規範與使用技巧總結
整理自生產環境最佳實踐,涵蓋命名、建表、索引、SQL 編寫、架構等 21 條核心準則。
一、命名規範 (1-12)
- 庫/表/字段全小寫 + 下劃線:避免
lower_case_table_names 導致的大小寫敏感問題。
- 長度 ≤ 32 字符:雖支援 64 字符,但統一規範利於識別與傳輸。
- 統一使用 InnoDB:支援事務、行鎖、崩潰恢復、多核/大內存/SSD 優化。
- 禁用保留字:否則需反引號包裹,增加腳本轉義複雜度。
- 禁止分區表:分區鍵限制多,DDL/Sharding/單表恢復困難,建議業務層手動分表。
- 非負數值用 UNSIGNED:同字節數下範圍翻倍(如 TINYINT: 0-255 vs -128-127)。
- IPv4 用 INT UNSIGNED 存儲:4 字節 vs CHAR(15) 15 字節,配合
INET_ATON/NTOA 轉換。
- 用 TINYINT 代替 ENUM:ENUM 修改需 DDL,數字枚舉易混淆默認值。
- 大小寫敏感字符串用 VARBINARY:無字符集開銷,比較更快。
- INT(n) 數字僅為顯示寬度:不限制存儲範圍。
- 區分 DATETIME 與 TIMESTAMP:優先用 TIMESTAMP(4 字節、自動初始化/更新),注意 5.5 前多列限制。
- 所有字段 NOT NULL:NULL 需額外標識位、B+樹不存 NULL、建議用 0/空串/特殊值代替。
二、MySQL 使用技巧 (13-21)
- 冷熱數據分表:大字段/低頻字段拆分,提升緩存命中、減少磁盤 IO。
- 禁存明文密碼:加密+隨機鹽值。
- 必有主鍵,推薦 UNSIGNED 自增:無主鍵 InnoDB 會生成隱藏列,影響定位與復制效率。
- 禁止冗餘索引:(a,b,c) 覆蓋 (a,b),利用前綴索引減輕維護。
- 禁止重複索引:PK + UNIQUE 同列無意義。
- 低基數列(如性別)不建索引:全表掃描往往更優。
- 善用覆蓋索引:避免回表,InnoDB 輔助索引存主鍵值,覆蓋索引可一次滿足。
- 用 IN 代替 OR,值<1000:IN 內部排序後範圍查找,效率更高。
- 字符集用 UTF8,Emoji 用 UTF8MB4:統一通用,避免亂碼。
- UNION ALL 代替 UNION:免去排序去重開銷。
- 禁用 ORDER BY RAND():生成磁盤臨時表,改用隨機主鍵再查詢。
- 高效分頁:
WHERE id > last_id ORDER BY id LIMIT 10 替代 LIMIT 10000,10。
- SELECT 只取必要列,禁 SELECT *:減少網絡、利用覆蓋索引、結構變更不影響業務。
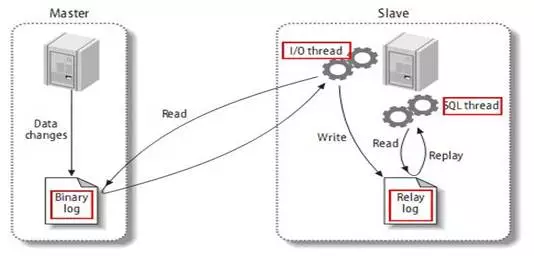
- 避免 NOW()/RAND() 等不確定函數:導致主從不一致、無法命中 Query Cache。
- 合理分庫分表策略:如千庫十表,利用多線程復制。
- 批量 SQL 減少交互:
INSERT ... ON DUPLICATE KEY UPDATE、REPLACE INTO、INSERT IGNORE。
- 拆分大事務/複雜 SQL:利用 Query Cache、減少鎖時間、發揮多核。
- 同表多 ALTER 合併執行:
ALTER TABLE t ADD COLUMN b VARCHAR(10), ADD INDEX idx_aa(aa); 減少鎖表重建次數。
- 避免存儲過程/觸發器/視圖/自定義函數:性能問題、Bug 多、阻礙 DDL/Sharding。
- 禁止應用賬號擁有 SUPER 權限:導致 read_only 失效,難以追蹤詭異問題。
- 業務邏輯上移,數據庫純存儲:邏輯與存儲分離,支撐快速迭代。