MySQL 遷移是 DBA 日常運維中不可避免的一項核心任務。簡單來說,遷移就是在確保資料完整性與業務連續性的前提下,將資料庫實例從一個物理或邏輯環境轉移至另一個環境。在生產環境中,通常由以下四大痛點驅動遷移需求:
核心原則只有一條:讓業務平穩、持續地運行。 所有遷移方案的設計,皆圍繞「如何快速、安全地完成備份與恢復」展開。
遷移的本質是「備份 + 傳輸 + 恢復 + 同步追趕」。工具選型取決於數據量級:
| 工具 | 適用場景 | 優缺點 |
|---|---|---|
| mysqldump | 小數據量 (< 10GB)、邏輯備份、跨版本遷移 | 產生 SQL 腳本,通用性強;但大數據量下鎖表久、速度慢、恢復耗時。 |
| xtrabackup (innobackupex) | 中大數據量 (GB~TB)、InnoDB 熱備份、物理備份 | 不鎖 InnoDB 表、支援增量備份、恢復快;需注意 MyISAM 表會被鎖定。 |
| rsync / 直接拷貝數據目錄 | 極大數據量、允許停機維護、同機房高速網絡 | 速度最快,受限於網絡帶寬;要求源庫停止服務以保證數據一致性。 |
| mydumper/myloader | 大數據量、多線程並行備份恢復 | 並行度高、速度快;但維護成本較高,社區活躍度不如 xtrabackup。 |
決策建議: 10GB 內用 mysqldump;TB 級首選 xtrabackup 或停機 rsync;跨機房低帶寬場景建議壓縮後傳輸。
以下場景假設:IP 末尾數字代表節點(如 101, 102),同機房用 D 段區分,跨機房用 C+D 段。所有操作均在從庫/備庫執行,嚴禁在主庫直接操作。
架構: 101 (主) -> 102 (舊從) 遷移至 103 (新從)
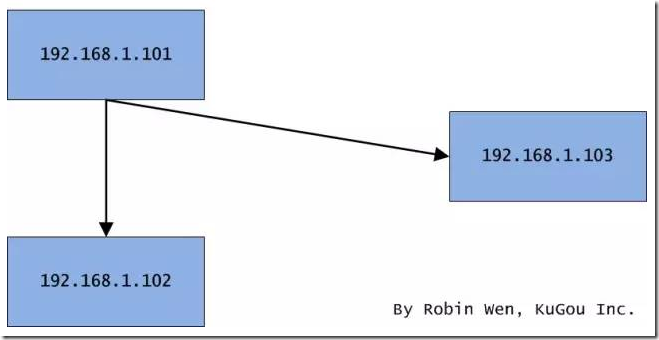
rsync -avhW --no-compress --progress 將 102 全量數據目錄拷貝至 103。REPLICATION SLAVE, REPLICATION CLIENT 權限。server_id (唯一)、數據目錄權限、配置文件路徑。SHOW SLAVE STATUS 中 Seconds_Behind_Master 遞減至 0。pt-table-checksum 校驗一致性 (或業務抽樣驗證) + 權限校驗 -> 研發切讀流量至 103 -> 觀察無誤遷移完成。關鍵點: 大數據量物理拷貝不鎖主庫,業務影響僅在「切讀流量」瞬間,風險最低。
架構: 101/102 遷移指定庫至 103 (新主) / 104 (新從),原主從最終廢棄。
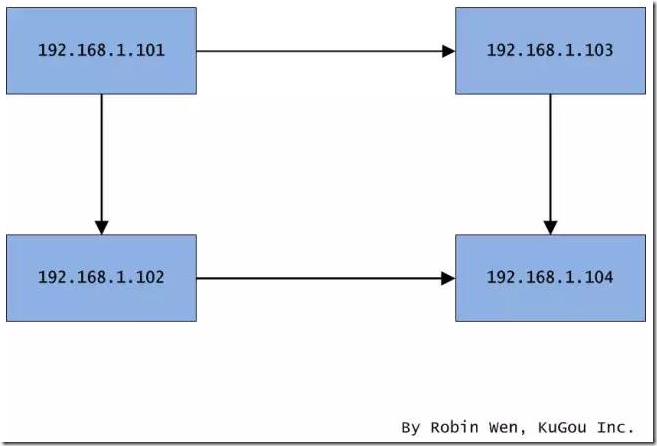
mysqldump --single-transaction --master-data=2 導出指定庫 (定時任務,業務低峰執行)。SHOW GRANTS)。架構: 101/102 拆分遷移至 103/104 (業務A) 與 105/106 (業務B)。
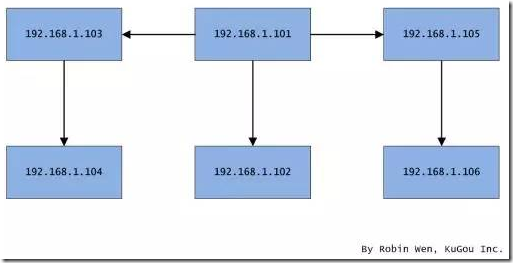
本質是場景二的兩次重複執行:先遷移業務A庫至 103/104,驗證切換;再遷移業務B庫至 105/106。核心難點在於權限隔離與業務切換順序的管控,建議制定詳細的變更單,分時段、分批次執行。
架構: 101/102 全量遷移至 103/104,原集群下線。核心策略:先建立新從 104,再將新主 103 掛在舊主 101 下,最後反向切換主從關係。
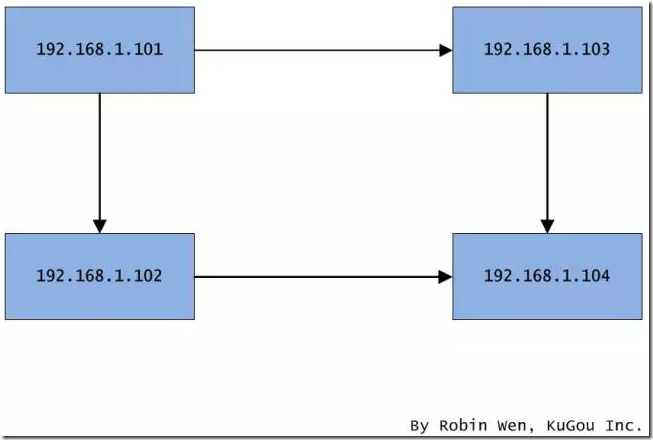
-- 在 104 上
STOP SLAVE;
-- 在 103 上
STOP SLAVE IO_THREAD;
STOP SLAVE SQL_THREAD; -- 記住 Master_Log_File, Read_Master_Log_Pos (即 Exec_Master_Log_Pos)
-- 在 104 上 追趕到 103 當前位點
START SLAVE UNTIL MASTER_LOG_FILE='xxx', MASTER_LOG_POS=yyy;
STOP SLAVE;
RESET SLAVE ALL; -- 清除舊主 101 信息
-- 在 103 上
SHOW MASTER STATUS; -- 記錄 File, Position
GRANT REPLICATION SLAVE ON *.* TO 'repl'@'104' IDENTIFIED BY 'pass';
-- 在 104 上
CHANGE MASTER TO MASTER_HOST='103', MASTER_LOG_FILE='xxx', MASTER_LOG_POS=yyy;
-- 重啟 104 MySQL (關鍵:RESET SLAVE ALL 後 Master_Server_Id 需重啟刷新)
-- 檢查 104 IO/SQL_THREAD 為 Yes
-- 在 103 上 START SLAVE;
-- 101 鎖表停寫
FLUSH TABLES WITH READ LOCK;
-- 確認 103 同步延遲為 0
-- 研發切寫流量至 103,讀流量至 104
UNLOCK TABLES; (101)
-- 斷開 103 -> 101 同步關係 (STOP SLAVE; RESET SLAVE ALL;)
避坑指南: 切換寫入時務必FLUSH TABLES WITH READ LOCK確保 101 靜止;RESET SLAVE ALL後必須重啟 MySQL 以刷新Master_Server_Id;全程監控Seconds_Behind_Master。
架構: A機房 1.101<->1.102 雙主同步 B機房 2.101<->2.102。需替換 A 機房主從為 1.103/1.104,保持雙主關係。
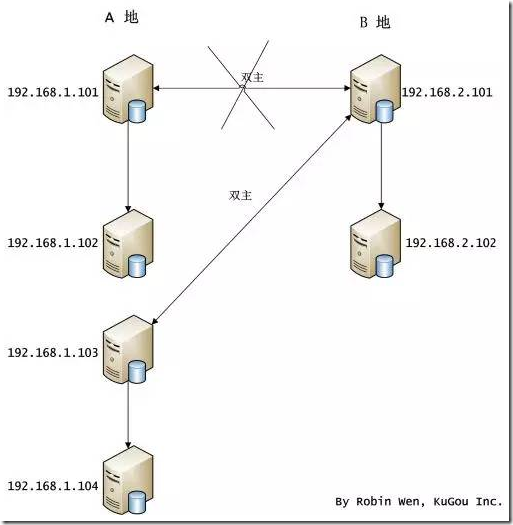
log_slave_updates 避免循環,或配置 auto_increment_offset/increment 區分奇偶)。跨機房難點: 網絡延遲導致同步延遲大,需預留足夠追趕時間;雙主auto_increment奇偶配置必須與舊主一致;log_slave_updates=ON是雙主傳遞 binlog 的前提。
架構: 1.113 (7936實例) 遷移至 2.117 (新建 7938, 7939 實例)。業務特點:部分庫只在 A 地寫,部分只在 B 地寫,涉及 replicate-ignore-db / replicate-wild-do-table 過濾規則。
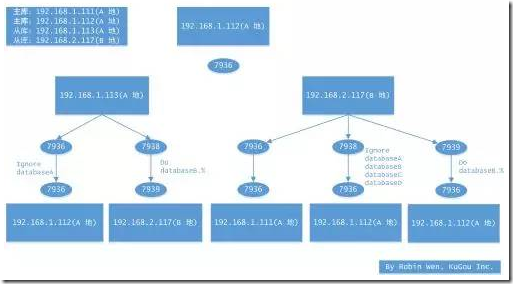
innobackupex --slave-info --databases='db1,db2' 備份指定實例。innobackupex --apply-log -> innobackupex --copy-back。replicate-ignore-db, replicate-wild-do-table, innodb_file_per_table=1, read_only=1, 唯一 server_id。CHANGE MASTER TO ... MASTER_LOG_FILE, MASTER_LOG_POS (參考 xtrabackup_slave_info 文件) -> START SLAVE。event_scheduler=ON。CHANGE MASTER TO 的 MASTER_LOG_FILE/POS 一旦出錯,必導致數據不一致,三核對再執行。$HOME,避免相對路徑災難。rm -rf 類操作雙人複核。mysqladmin -S /tmp/mysql_3306.sock shutdown 指定 Socket,防誤關其他實例。read_only=1 (超級用戶除外),防誤寫入導致主從斷裂。server_id 必須唯一,否則同步報錯。replicate-ignore-db (庫級) 與 replicate-wild-do-table (表級) 邏輯勿混淆,測試驗證。innodb_file_per_table=1,避免 ibdata1 膨脹導致備份傳輸極慢。gzip 壓縮完成會刪除源文件,備份文件傳輸前確認是否需要保留原檔。xtrabackup 會鎖 MyISAM 表,遷移前務必掃描 SELECT TABLE_SCHEMA, TABLE_NAME FROM INFORMATION_SCHEMA.TABLES WHERE ENGINE='MyISAM',轉 Engine 或單獨處理。Relay_Master_Log_File (主庫 Binlog 文件) + Exec_Master_Log_Pos (SQL 線程已執行位點),而非 Master_Log_File / Read_Master_Log_Pos (IO 線程讀到位點)。rsync -avhW --no-compress --progress | expect -c "spawn ...; interact" & nohup,斷點續傳、免密、後台、進度可視。innobackupex --stream=xbstream --compress /backup | gzip > backup.xb.gz,落盤即壓縮,節省 IOPS。--throttle=100 (每秒 10MB) 保護業務 IO;--parallel=4 加速 (配合 --stream 時無效)。rsync -avhW --no-compress --progress /src/ /dst/ 比 cp 快且可斷點續傳。回顧全文,MySQL 遷移的核心邏輯可歸納為三層:
工具與命令會迭代 (如 xtrabackup 逐漸被 MySQL Shell / Mydumper 替代,GTID 取代文件位點),但「備份->傳輸->恢復->同步追趕->驗證->切換->觀察」的工程化閉環思維永遠不變。正如文末所言:「證明自己有能力最重要的一點,就是讓一切都在自己的掌控之中。」