分布式存儲架構:MySQL 雙主雙寫雙向同步復制設計與避坑指南
核心問題與制約
雙主雙寫並雙向同步場景下,核心挑戰在於:
- 數據一致性衝突:同庫、同表、同記錄、同字段在兩地同時修改,復制層無法判斷以哪邊為準。
- 主鍵衝突:自增主鍵在兩個主庫上極易產生重複,必須避免使用數據庫原生自增方案(可採用 UUID、雪花算法或預分段自增)。
- 循環復制風險:復制程序寫入也會產生 binlog,若不加過濾,會導致 A→B→A 無限循環。
原生 Dual Master 方案分析
MySQL 內建雙主復制通過 server-id 標識 binlog 來源,配合 --log-slave-update=OFF 可避免 slave 重寫 binlog,從源頭阻斷循環。但此方案強耦合 MySQL 配置,大規模部署時配置錯誤風險高,且未解決主鍵衝突與業務層數據衝突。
自定義標記 SQL 方案(解耦實現)
為解耦 MySQL 配置,採用「標記 SQL」機制:
- 復制程序寫入事務時,在事務首尾插入特定標記 SQL(更新一張專用標記表)。
- 標記 SQL 進入 binlog,復制程序讀取 binlog 時識別標記,判斷該事務為復制產生,從而過濾掉,實現回環控制。
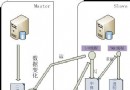
Binlog 事務結構示意
- 綠色區:業務正常事務。
- 紅色區:復制程序寫入事務(含藍色標記 SQL)。
批量讀取 binlog 的 5 種邊界情況
- 讀取範圍全在綠色區。
- 起點在綠色區,終點在紅色區。
- 起點在紅色區,終點在綠色區。
- 起點終點在綠色區,但中間跨越紅色區。
- 讀取範圍全在紅色區(高風險):一個事務被拆成三段,中段缺少首尾標記,無法識別,導致循環同步。
解決方案
將復制程序的批量讀取窗口固定為 ≥ 寫入事務的最大長度,確保不會出現情況 5,從而保證每次讀取要么完整包含一個事務(含首尾標記),要么完全不包含復制事務。
總結與建議
- 雙向同步復制的關鍵在於 標記識別 與 讀取窗口控制。
- 同庫同表同記錄同字段的雙寫衝突,復制層無法仲裁,建議:
① 業務設計規避(分片、路由);
② 若不可避免,採用「最後寫入勝」(LWW)策略,但需注意時鐘同步誤差。
③ 最佳實踐:在架構層面消除雙寫場景。