在資料庫開發中,INSERT、UPDATE、DELETE 是最基礎也最常用的三大操作。本文將系統梳理 MySQL 中這三類語句的核心語法、進階用法,並針對自增主鍵衝突、跨表數據遷移、批量操作效能等實戰場景進行深度解析,幫助你寫出更高效、更穩健的 SQL。
當需要將一張表的查詢結果批量寫入另一張表時,INSERT INTO ... SELECT 是首選方案,MySQL 與 SQL Server 均支援此語法。
INSERT INTO table_name1 (column_list1)
SELECT column_list2 FROM table_name2 WHERE condition;
person_old 遷移數據到 personCREATE TABLE person ( id INT UNSIGNED NOT NULL AUTO_INCREMENT, NAME CHAR(40) NOT NULL DEFAULT '', age INT NOT NULL DEFAULT 0, info CHAR(50) NULL, PRIMARY KEY (id) ); CREATE TABLE person_old ( id INT UNSIGNED NOT NULL AUTO_INCREMENT, NAME CHAR(40) NOT NULL DEFAULT '', age INT NOT NULL DEFAULT 0, info CHAR(50) NULL, PRIMARY KEY (id) ); INSERT INTO person_old VALUES (11,'Harry',20,'student'),(12,'Beckham',31,'police'); -- 跨表批量插入 INSERT INTO person (id, NAME, age, info) SELECT id, NAME, age, info FROM person_old;
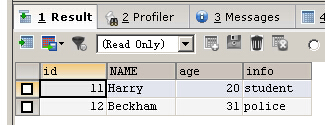
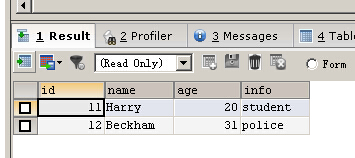
避坑指南: 若目標表主鍵為自增,插入時若無法保證 id 唯一,建議省略主鍵欄位,讓資料庫自動分配;若強制指定且發生重複,會拋出主鍵衝突錯誤。
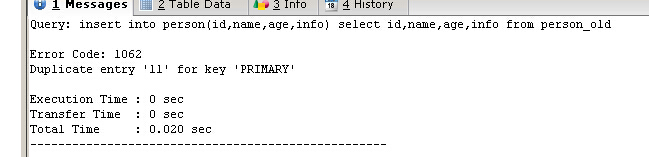
MySQL 提供三種方案,SQL Server 則需顯式開啟 IDENTITY_INSERT:
DELETE + INSERT 觸發器-- 方案一:IGNORE 跳過重複 INSERT IGNORE INTO person (id, NAME, age, info) SELECT id, NAME, age, info FROM person_old;
MySQL 允許在插入時:
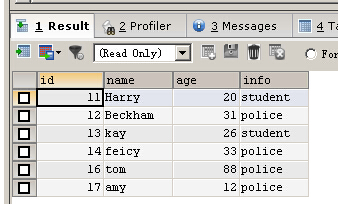
id = NULL → 自動分配下一個自增值id → 只要不衝突即可id 欄位 → 自動分配INSERT INTO person (id, NAME, age, info) VALUES (NULL, 'feicy', 33, 'student');
INSERT IGNORE INTO person (id, NAME, age, info) VALUES (16, 'tom', 88, 'student');
INSERT IGNORE INTO person (NAME, age, info) VALUES ('amy', 12, 'bb');
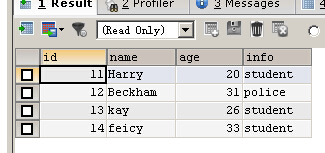
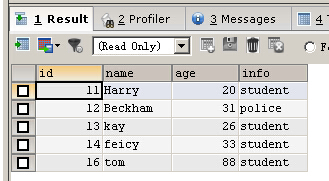
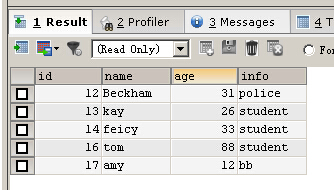
MySQL 允許唯一索引欄位存在多個 NULL;SQL Server 則視為重複值並拒絕。
-- MySQL:可重複插入 NULL
INSERT INTO test(a) VALUES (NULL);
INSERT INTO test(a) VALUES (NULL); -- 成功
UPDATE person SET info = 'police' WHERE id BETWEEN 14 AND 17;
DELETE FROM person WHERE id BETWEEN 14 AND 17; — 可帶條件,觸發觸發器,逐行刪除,較慢TRUNCATE TABLE person; — 清空全表,不觸發觸發器,重置自增計數器,速度極快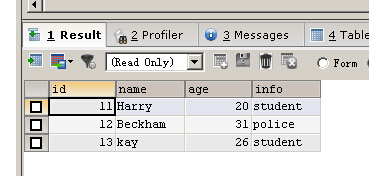
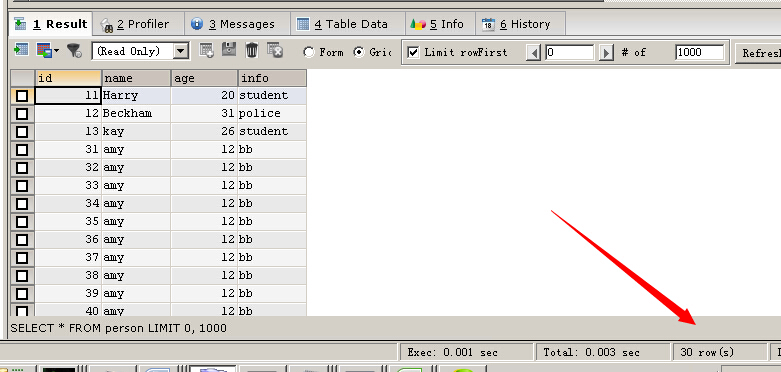
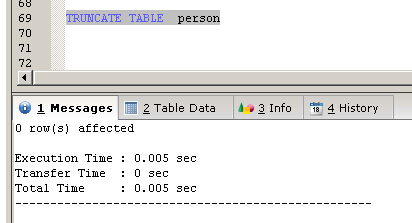
最佳實踐: 需清空全表且不保留自增值時,優先用TRUNCATE;需條件刪除或依賴觸發器時用DELETE。
本文涵蓋了 MySQL 增刪改的核心語法、跨表批量遷移、主鍵衝突三種解法、自增主鍵靈活用法、唯一索引 NULL 語義差異、以及 DELETE vs TRUNCATE 的效能對比。從 SQL Server 遷移到 MySQL 時,重點適應「自增主鍵可顯式指定或省略」、「IGNORE/ON DUPLICATE KEY UPDATE 解決衝突」、「TRUNCATE 重置自增」這三大思維差異,即可寫出更地道、高效的 MySQL SQL。