索引是查詢性能的核心。MySQL 默認 InnoDB 使用 B+樹索引,理解其存儲結構、最左前綴原理、覆蓋索引、頁分裂機制,能指導索引設計與 SQL 優化。本文結合 EXPLAIN 實戰演示。
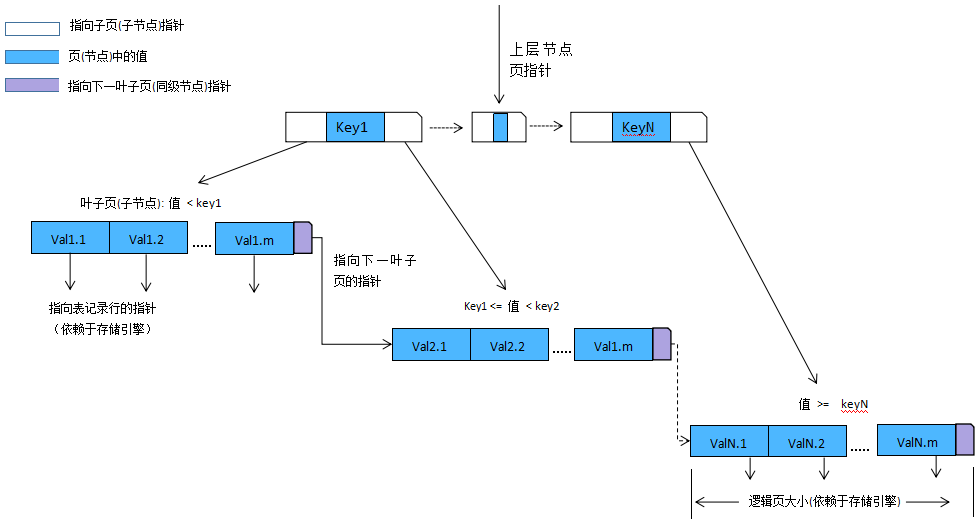
主鍵選擇關鍵:自增整數 保證插入順序,避免頻繁頁分裂與碎片。UUID、MD5 等無序值會導致大量隨機插入、頁分裂連鎖、性能崩塌。
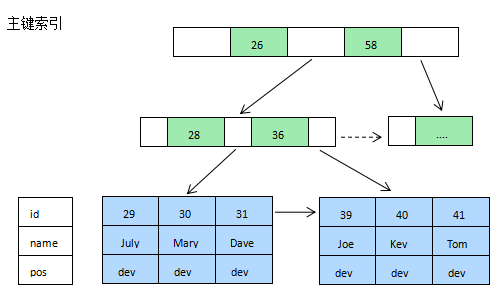
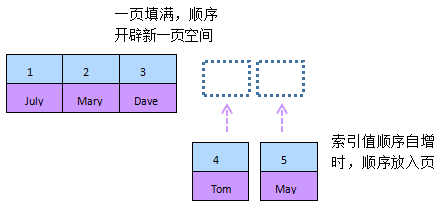
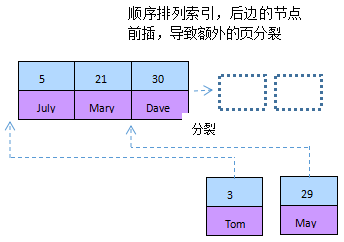
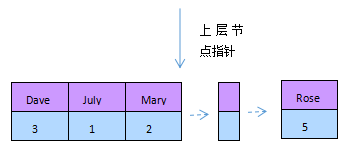
表 staffs(id PK, name, age, pos, add_time),建復合索引 idx_nap(name, age, pos)。
可用索引的場景(EXPLAIN 驗證):
WHERE name='July' AND age=23 AND pos='dev' → 用全索引。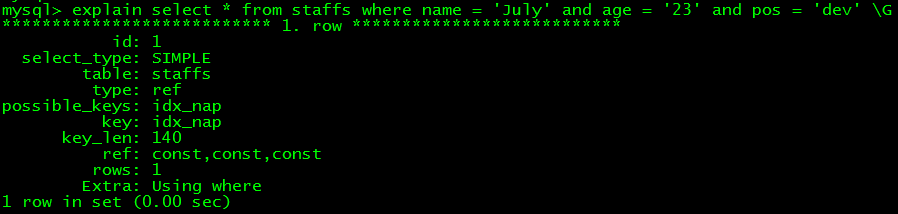
WHERE name='July' AND age=23、WHERE name='July' → 用部分索引,key_len 縮短。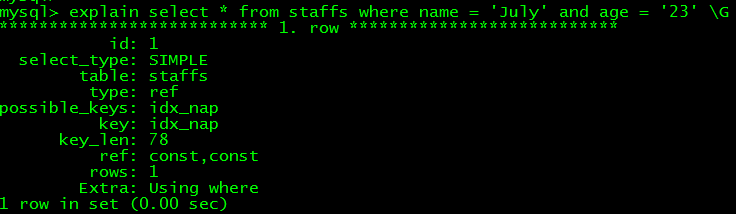
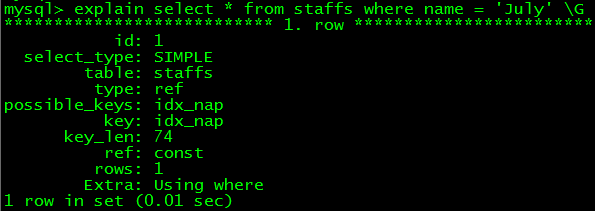
WHERE name LIKE 'J%' → 用索引;LIKE '%y'、LIKE '%u%' → 不可用。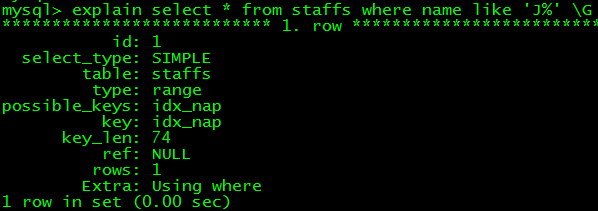
WHERE name > 'Mary' 可用,但字符串 >= 可能失效(版本差異),時間/整型較穩定。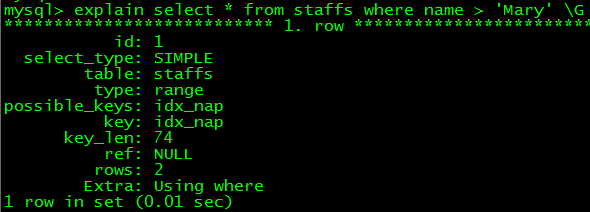
WHERE name='July' AND age > 25 → 用 name、age 兩列。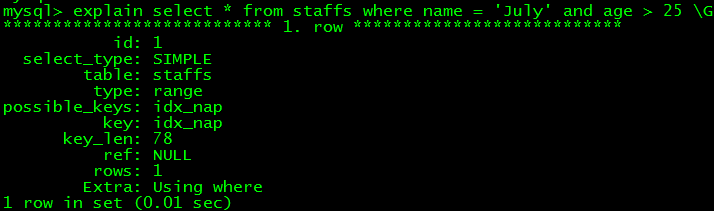
SELECT name,age,pos FROM ... WHERE ... 查詢列恰好包含在索引中,Extra: Using index,無需回表。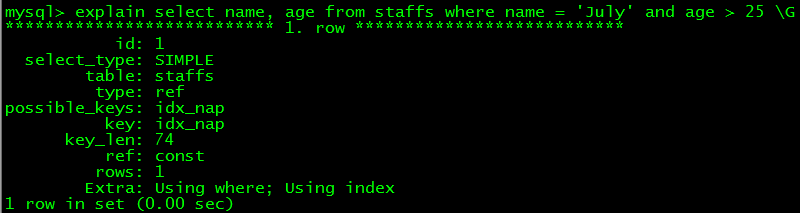
WHERE a=1 AND c=3 僅用 a;WHERE b=2 AND c=3 全不用。WHERE a=1 AND b>2 AND c=3 僅用 a、b。WHERE c=3 AND b=2 AND a=1 全不用。WHERE SUBSTR(a,1,3)='hhh' 失效。LIKE '%abc' 失效。ORDER BY 遵循最左前綴:ORDER BY a,b 可用,ORDER BY b、ORDER BY a ASC, b DESC(方向不一致)不可用。
對長 VARCHAR/TEXT 取前 N 字符建索引。選擇性 = COUNT(DISTINCT LEFT(col,N))/COUNT(*),選擇性趨近 1 時代表前綴足夠區分。
ALTER TABLE tab ADD INDEX idx_name(name(9));
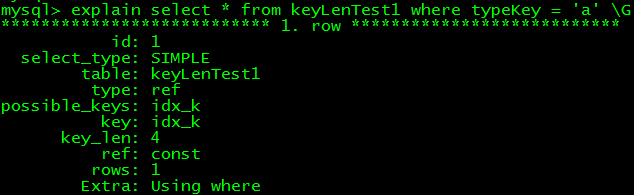
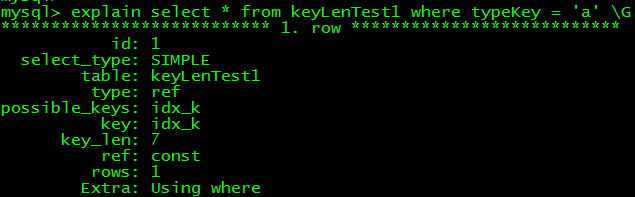
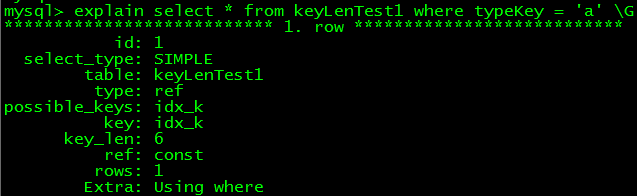
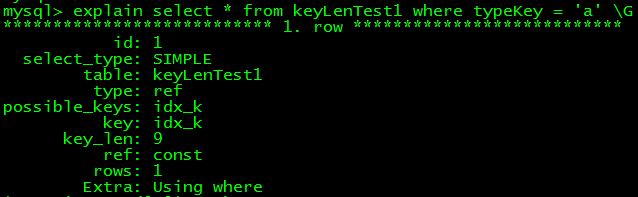
通過 EXPLAIN 的 key_len 推算實際用到哪些列(基於 utf8):
INT:5 字節(4+1 NULL 標誌)CHAR(N):首列 4 字節(3+1),後續每列 +3 字節VARCHAR(N):首列 6 字節(長度 2 字節 + 內容 3 字節 + NULL 1 字節),後續 +3 字節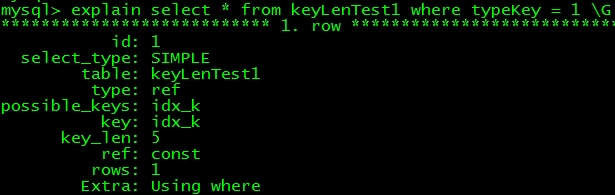
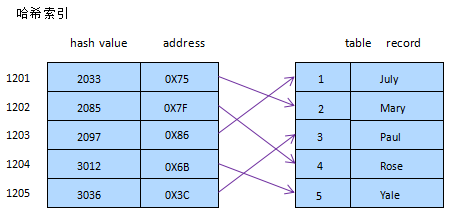
僅支持 =/IN 精確查詢,不支持範圍、排序、最左前綴;適用於高選擇性列。碰撞多時維護成本高。