延續基礎入門,本文深入講解 MySQL 最核心的 SELECT 語句進階用法,涵蓋簡單查詢、條件過濾、計算欄位、聚合分組、子查詢、內/外連接、聯合查詢、笛卡爾積等完整知識體系,配合實戰案例與效能提示,打堅實查詢基本功。
-- 簡單語法
SELECT [欄位列表] FROM 表名 WHERE 條件;

-- 完整語法
SELECT select_list
  [INTO new_table_name]
  FROM table_list
  [WHERE search_conditions]
  [GROUP BY group_by_list]
  [HAVING search_conditions]
  [ORDER BY order_list [ASC | DESC]]
  [LIMIT [offset,] row_count];
子句執行順序(邏輯): FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT。理解此順序對寫出正確查詢至關重要(如 WHERE 不能用 SELECT 別名,HAVING 可用聚合函數)。
-- 查詢指定欄位
SELECT sname, mark FROM student;

-- 別名(AS 可省略,建議保留)
SELECT sname, sid AS id FROM student;

-- 常量欄位
SELECT sid, sname, '自動化班' AS `2014級` FROM student;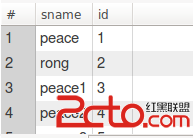
-- 語法:LIMIT [offset,] count
-- offset 從 0 開始,即「跳過前 offset 行」
SELECT * FROM student LIMIT 1, 3;      -- 跳過 1 行,取 3 行(第 2-4 行)
SELECT * FROM student LIMIT 3 OFFSET 1; -- 等價寫法

-- 結合排序分頁
SELECT * FROM student ORDER BY sid DESC LIMIT 1, 3;
⚠️ 子句順序:
ORDER BY必須在LIMIT之前,否則報錯。
| 操作符 | 含義 | 範例 |
|---|---|---|
= | 等於 | sid = 2 |
<> / != | 不等於 | sid <> 2 |
>, >=, <, <= | 大於/大於等於/小於/小於等於 | mark > 80 |
BETWEEN ... AND ... | 範圍(含邊界) | sid BETWEEN 2 AND 4 |
IS NULL / IS NOT NULL | 空值判斷 | sgender IS NULL |
IN (列表) | 離散集合匹配 | sid IN (1,2,3) |
NOT IN (列表) | 排除離散集合 | sid NOT IN (1,2,3) |
LIKE '模式' | 模糊匹配 | sname LIKE '%eac%' |
REGEXP '正則' | 正則表達式匹配 | sname REGEXP 'ong' |
AND 優先級高於 OR(sid=1 OR sid=2) AND mark > 1| 符號 | 含義 | 範例匹配 |
|---|---|---|
% | 任意長度字串(含 0 字元) | '%eac%' 含 "eac" 的任意字串 |
_ | 單一字元 | '_eace' 首字元任意、後接 "eace" |
REGEXP | 正則表達式(MySQL 使用 Henry Spencer 實現) | '[peac,ron]' 含 p/e/a/c/r/o/n 任一字元 |
SELECT CONCAT(sname, '(', sid, ')') AS sname FROM student;
SELECT sid, sname, sid * mark AS imark FROM student;| 類別 | 函數 | 說明 |
|---|---|---|
| 字串 | CONCAT() | 拼接 |
UPPER()/LOWER() | 大小寫轉換 | |
SUBSTRING()/LEFT()/RIGHT() | 截取 | |
TRIM()/LTRIM()/RTRIM() | 去空白 | |
LENGTH()/CHAR_LENGTH() | 長度(字節/字元) | |
REPLACE() | 替換 | |
| 日期時間 | NOW()/CURDATE()/CURTIME() | 當前日期時間/日期/時間 |
DATE()/TIME() | 提取日期/時間部分 | |
DATE_FORMAT() | 格式化輸出 | |
DATE_ADD()/DATE_SUB() | 日期加減 | |
DATEDIFF() | 日期差天數 | |
| 數值 | ABS()/ROUND()/FLOOR()/CEIL() | 絕對值/四捨五入/向下/向上取整 |
MOD() | 取模 | |
POWER()/SQRT() | 冪/平方根 | |
RAND() | 隨機數 |
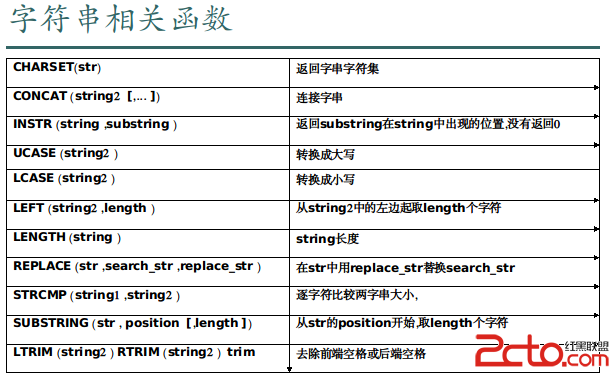
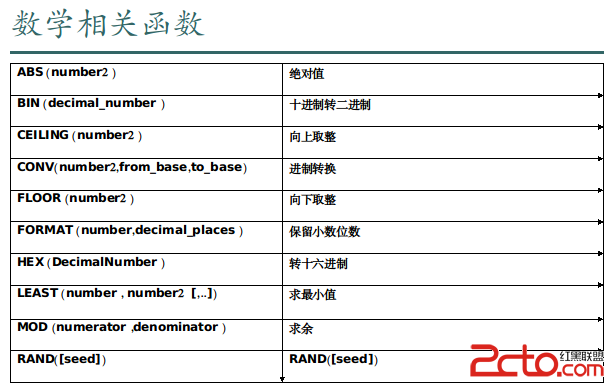
-- 字串處理
SELECT sname, UPPER(sname) FROM student;

-- 日期查詢:某日訂單
SELECT c_id, order_num FROM orders WHERE DATE(order_date) = '2015-11-04';

-- 數值處理:偶數 sid
SELECT sid, sname FROM student WHERE MOD(sid, 2) = 0;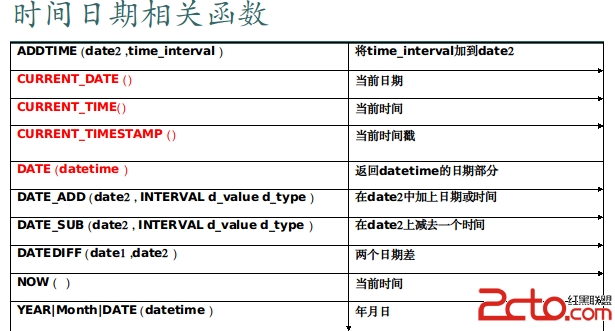
| 函數 | 說明 | 範例 |
|---|---|---|
COUNT(*) | 行數(含 NULL) | COUNT(*) |
COUNT(col) | 非 NULL 行數 | COUNT(sage) |
SUM(col) | 求和 | SUM(sid) |
AVG(col) | 平均值 | AVG(sid) |
MAX()/MIN() | 最大/最小值 | MAX(sid) |
SELECT AVG(DISTINCT mark) FROM student;
-- 按 mark 分組統計人數
SELECT mark, COUNT(*) AS num FROM student GROUP BY mark;

-- 先過濾再分組再過濾組
SELECT mark, COUNT(*) AS num
FROM student
WHERE sid > 1
GROUP BY mark
HAVING num > 2;
WHERE vs HAVING 核心差異:
WHERE:分組**前**過濾行,不能用聚合函數HAVING:分組**後**過濾組,**可用聚合函數**- 能用 WHERE 解決的絕不用 HAVING(效能更好)
-- 類型 1:標量子查詢(返回單值)
SELECT * FROM products
WHERE unit_price > (SELECT AVG(unit_price) FROM products);

-- 類型 2:列子查詢(返回單列多行)配合 IN/ANY/ALL
SELECT * FROM goods
WHERE goods_id IN (SELECT goods FROM detil);

-- 類型 3:作為計算欄位(相關子查詢)
SELECT *,
  (SELECT COUNT(*) FROM detil WHERE detil.goods = goods.goods_id) AS id_count
FROM goods;
-- 兩表內連接(兩種等價寫法)
SELECT d.customer_id, g.goods_name, g.goods_price, d.count,
       g.goods_price * d.count AS expensive
FROM goods g INNER JOIN detil d ON g.goods_id = d.goods;
-- 或
SELECT ... FROM goods g, detil d WHERE g.goods_id = d.goods;

-- 三表內連接
SELECT *
FROM (t1 INNER JOIN t2 ON t1.id = t2.id)
INNER JOIN t3 ON t1.id = t3.id;

-- 自連接(找同一廠商生產的其他商品)
SELECT p1.goods_name, p1.goods_maker
FROM goods p1, goods p2
WHERE p1.goods_maker = p2.goods_maker AND p2.goods_name = '餅干4';| 類型 | 語法 | 結果集 |
|---|---|---|
| 左連接 | LEFT [OUTER] JOIN | 左表所有行 + 右表匹配行(無匹配則 NULL) |
| 右連接 | RIGHT [OUTER] JOIN | 右表所有行 + 左表匹配行 |
-- 左連接:顯示所有商品,即使無訂單
SELECT d.customer_id, g.goods_name, g.goods_price, d.count,
       g.goods_price * d.count AS expensive
FROM goods g LEFT OUTER JOIN detil d ON g.goods_id = d.goods
ORDER BY d.customer_id;
-- UNION:合併結果並去重(欄位數、型別需一致)
SELECT goods_id, goods_name FROM goods WHERE goods_id > 2
UNION
SELECT goods_id, goods_name FROM goods WHERE goods_name IN ('餅干1','餅干3')
ORDER BY goods_id;

-- UNION ALL:合併結果不去重(效能更好,業務允許重複時優先使用)
SELECT ... UNION ALL SELECT ...
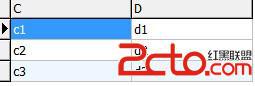
-- 兩表無連接條件 = 笛卡爾積(行數相乘,極度危險)
SELECT * FROM goods, detil;  -- 或 CROSS JOIN

-- 明確語法
SELECT * FROM goods CROSS JOIN detil;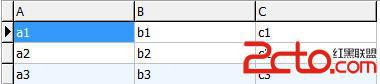
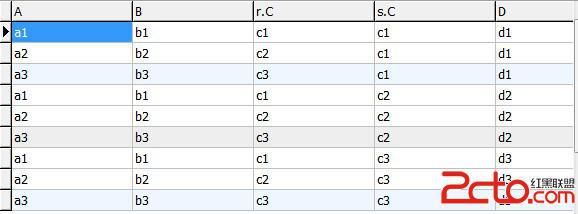
⚠️ 生產禁用: 除非極少數測試場景,**嚴禁在生產環境使用笛卡爾積**,會導致資源耗盡。
| 場景 | 建議 | 避免 |
|---|---|---|
| 大表分頁 | 游標分頁 WHERE id > last_id LIMIT 20 | LIMIT 100000, 20 深分頁 |
| 模糊查詢 | 前綴匹配 LIKE 'abc%'(可用索引) | LIKE '%abc%' 全表掃描 |
| OR 條件 | 改用 UNION ALL 或 IN | col=1 OR col=2 導致索引失效 |
| 子查詢 | 優先改寫為 JOIN 或 EXISTS | 相關子查詢在大表中 |
| SELECT * | 顯式列出欄位 | SELECT * 增加網路/解析開銷 |
| 隱式轉換 | 字串比字串、數字比數字 | varchar_col = 123 觸發轉換失效索引 |
SELECT-FROM-WHERE-GROUP BY-HAVING-ORDER BY-LIMIT 完整語句WHERE (行過濾) vs HAVING (組過濾) 本質差異INNER/LEFT/RIGHT JOIN,能畫出文氏圖對應結果集EXISTS 替代 IN、UNION ALL 替代 UNION 優化效能LIKE '%...%'、函數(欄位)、隱式轉換 三大索引殺手EXPLAIN 分析執行計畫,識別 type=ALL (全表掃描)、Using filesort、Using temporary進階方向: 窗口函數 (
ROW_NUMBER(),LAG())、CTE (WITH)、側向連接 (LATERAL JOIN)、JSON 查詢、全文檢索、空間數據(GIS)。MySQL 8.0 已完整支援 ANSI SQL:2011 核心特性,建議以 8.0 為學習基準。