某電商系統圖片表 pics,數據量近 100 萬行。高頻查詢:根據 user_id 獲取用戶圖片集合。
-- 表結構簡化
CREATE TABLE pics (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    user_id BIGINT NOT NULL,
    picname VARCHAR(255),
    smallimg VARCHAR(255),
    INDEX idx_user_id (user_id)  -- 原有單列索引
);
-- 目標查詢
SELECT picname, smallimg FROM pics WHERE user_id = 17853;為排除查詢緩存干擾,使用 SQL_NO_CACHE 強制繞過緩存:
SELECT SQL_NO_CACHE picname, smallimg FROM pics WHERE user_id = 17853;執行 10 次平均耗時 40ms。
EXPLAIN SELECT SQL_NO_CACHE picname, smallimg FROM pics WHERE user_id = 17853;
type=ref:非唯一索引查找key=idx_user_id:使用單列索引Extra:無 Using index,需回表 查詢 picname、smallimg創建聯合索引 (user_id, picname, smallimg),使查詢列完全包含於索引中:
ALTER TABLE pics ADD INDEX idx_user_pic (user_id, picname, smallimg);重新執行 10 次,平均耗時降至 30ms(提升 25%)。

key=idx_user_pic:使用新聯合索引Extra=Using index:覆蓋索引生效,無需回表核心原理:InnoDB 聚簇索引葉子節點存放完整行數據,輔助索引葉子節點存放索引列值 + 主鍵值。覆蓋索引將查詢所需列全部包含在輔助索引中,MySQL 僅掃描索引樹即可滿足查詢,避免了「索引查主鍵 → 回表查完整行」的雙重 IO。
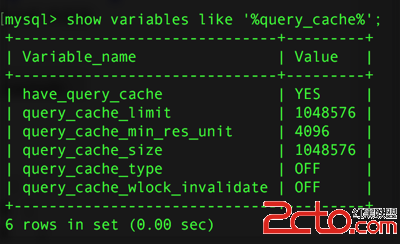
| 參數 | 含義 | 調優建議 |
|---|---|---|
| have_query_cache | 是否支持查詢緩存 | YES 表示啟用 |
| query_cache_size | 緩存總內存大小,0 為禁用 | 根據命中率調整,過大反增鎖開銷 |
| query_cache_type | 緩存模式:ON/DEMAND/OFF | DEMAND 配合 SQL_CACHE 更可控 |
| query_cache_limit | 單次查詢結果最大可緩存大小 | 默認 1MB,大結果集不宜緩存 |
| query_cache_min_res_unit | 內存分配最小塊(默認 4KB) | 見下文計算公式調優 |
-- 禁止本次查詢結果被緩存(不影響本次是否讀取緩存)
SELECT SQL_NO_CACHE picname, smallimg FROM pics WHERE user_id = 17853;

-- 顯式要求緩存(需 query_cache_type=DEMAND)
SELECT SQL_CACHE picname, smallimg FROM pics WHERE user_id = 17853;關鍵誤區:
SQL_NO_CACHE並非「本次查詢不使用緩存」,而是「本次查詢結果不存入緩存供後續查詢使用」。若需強制繞過緩存讀取,需重置緩存RESET QUERY CACHE或修改表數據導致緩存失效。
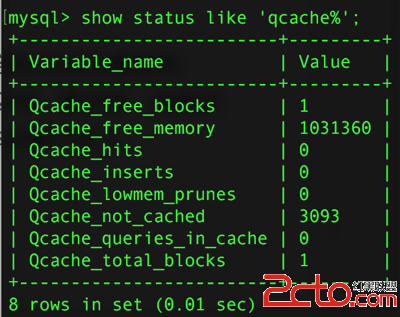
緩存分配按 query_cache_min_res_unit 分塊,未用完的內存會被 Trim 歸還,產生碎片。關鍵指標:
Qcache_free_blocks 過大 → 碎片嚴重 → FLUSH QUERY CACHE 整理(不清空內容)Qcache_lowmem_prunes 過大 → 緩存空間不足 → 增加 query_cache_size最佳單元大小計算:
query_cache_min_res_unit = (query_cache_size - Qcache_free_memory) / Qcache_queries_in_cache原查詢:
SELECT id, title, content FROM article ORDER BY created DESC LIMIT 10000, 10;問題:大偏移量導致掃描大量行再丟棄。
優化:子查詢只取主鍵 + 覆蓋索引,再回表:
SELECT a.id, a.title, a.content
FROM article a
INNER JOIN (
    SELECT id FROM article ORDER BY created DESC LIMIT 10000, 10
) b USING (id);
創建聯合索引 (created, id)(InnoDB 輔助索引自帶主鍵),子查詢走 Using index,極速定位 10 個 ID,主查詢僅 10 次主鍵回表。
InnoDB 輔助索引葉子節點存儲主鍵值,故主鍵查詢永遠覆蓋索引。例如 SELECT id FROM table WHERE secondary_col = ? 直接命中輔助索引無需回表。