MySQL 性能優化無法一蹴而就,必須從表設計、索引策略、架構拆分、讀寫分離、存儲過程、參數配置、硬體升級、日常維護八大維度協同推進。本文梳理完整知識體系,並深入實戰 EXPLAIN 分析與慢查詢定位,作為系列首篇奠基。
max_connections、innodb_buffer_pool_size 等核心參數調優。OPTIMIZE TABLE;InnoDB 依賴自動合併。此外,善用存儲過程亦能提升性能。
| 範式 | 核心約束 | 通俗說法 |
|---|---|---|
| 1NF | 屬性原子性 | 每個欄位不可再拆分(關係型資料庫天然滿足) |
| 2NF | 記錄唯一性 | 每行有唯一標識(主鍵),無部分依賴 |
| 3NF | 字段無冗餘 | 非主鍵欄位不傳遞依賴於主鍵 |
嚴格 3NF 雖消除冗餘,但可能導致頻繁多表 JOIN,查詢效率下降。策略:概念模型遵循 3NF,物理模型適度降級。
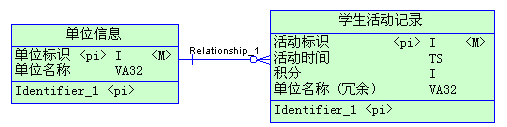
場景:單位表 500 行,學生活動表 200 萬行。為查詢效率在活動表冗餘「單位名稱」。

訂單表冗餘 Price 總價(可從明細表加總得出)。
-- 會話級 / 全域級
SHOW [SESSION|GLOBAL] STATUS LIKE 'Com_%';
-- 重點:Com_select, Com_insert, Com_update, Com_delete 掌握讀寫比例
SHOW GLOBAL STATUS LIKE 'Connections';   -- 連接嘗試次數
SHOW GLOBAL STATUS LIKE 'Uptime';        -- 運行秒數
SHOW GLOBAL STATUS LIKE 'Slow_queries';  -- 慢查詢次數(預設 >10s)
SHOW VARIABLES LIKE 'long_query_time';  -- 查看預設 10s
SET GLOBAL long_query_time = 2;         -- 臨時改為 2s(永久需改 my.cnf)

-- 5.5+ 在 my.cnf [mysqld] 區塊
slow_query_log = 1
slow_query_log_file = /var/log/mysql/slow.log
-- 5.6+ 預設已開啟,檢查 datadir 確認路徑
-- 表結構
CREATE TABLE `emp` (
  `empno` MEDIUMINT UNSIGNED NOT NULL DEFAULT 0,
  `ename` VARCHAR(20) NOT NULL DEFAULT '',
  `job` VARCHAR(9) NOT NULL DEFAULT '',
  `mgr` MEDIUMINT UNSIGNED NOT NULL DEFAULT 0,
  `hiredate` DATE NOT NULL,
  `sal` DECIMAL(7,2) NOT NULL,
  `comm` DECIMAL(7,2) NOT NULL,
  `deptno` MEDIUMINT UNSIGNED NOT NULL DEFAULT 0
) ENGINE=MyISAM DEFAULT CHARSET=utf8;

-- 隨機字串函數
CREATE FUNCTION rand_string(n INT) RETURNS VARCHAR(255)
BEGIN
  DECLARE chars_str VARCHAR(100) DEFAULT 'abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ';
  DECLARE return_str VARCHAR(255) DEFAULT '';
  DECLARE i INT DEFAULT 0;
  WHILE i < n DO
    SET return_str = CONCAT(return_str, SUBSTRING(chars_str, FLOOR(1+RAND()*52), 1));
    SET i = i + 1;
  END WHILE;
  RETURN return_str;
END;

-- 批量寫入存儲過程(關閉自動提交加速)
CREATE PROCEDURE insert_emp(IN start INT, IN max_num INT)
BEGIN
  DECLARE i INT DEFAULT 0;
  SET autocommit = 0;
  REPEAT
    SET i = i + 1;
    INSERT INTO emp VALUES (start+i, rand_string(6), 'SALESMAN', 1, CURDATE(), 2000, 400, RAND());
  UNTIL i = max_num END REPEAT;
  COMMIT;
END;

-- 呼叫:生成 400 萬測試行
CALL insert_emp(100001, 4000000);
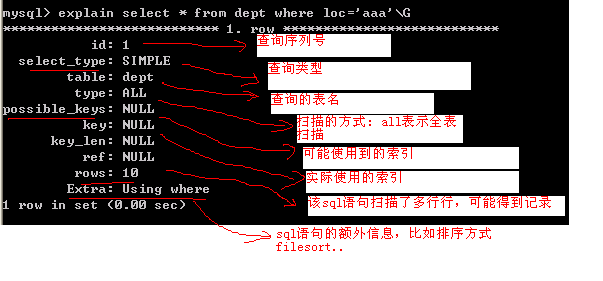
EXPLAIN SELECT * FROM emp WHERE ename='JKLOIP'\G
| 欄位 | 含義 | 關鍵判讀 |
|---|---|---|
| id | SELECT 識別符 | 數字越大越先執行;相同則按順序 |
| select_type | 查詢類型 | PRIMARY(最外層)、SUBQUERY、DERIVED(衍生表)、UNION 等 |
| table | 輸出結果集的表 | |
| type | 訪問類型(最關鍵) | ALL(全表掃描) > index > range > ref > eq_ref > const > system 目標:至少達到 ref,最好 range 或更優 |
| possible_keys | 可能用到的索引 | 為 NULL 表示無索引可用 |
| key | 實際使用的索引 | 與 possible_keys 對比,若為 NULL 需建索引 |
| key_len | 索引長度 | 推斷聯合索引用了幾個欄位 |
| rows | 預估掃描行數 | 越小越好;InnoDB 為估算值 |
| Extra | 額外信息 | Using filesort(需優化)、Using temporary(臨時表)、Using index(覆蓋索引✓)、Using where(WHERE 過濾) |
Using filesort:ORDER BY 無法用索引排序 → 加索引或調整排序欄位。Using temporary:GROUP BY/DISTINCT 需臨時表 → 檢查索引順序。Using index:覆蓋索引,無需回表 → 極佳。Impossible WHERE:優化器判定無結果 → 條件衝突。
-- 慢:子查詢 + ORDER BY 導致 filesort,400 萬行耗時 1min+
SELECT * FROM emp WHERE empno = (SELECT empno FROM emp WHERE ename='研發部') ORDER BY empno;

-- 快:JOIN 利用索引
SELECT * FROM emp e JOIN dept d ON e.deptno = d.deptno WHERE e.empno = 100002;
本文建立了「設計→SQL→參數→硬體」四層優化模型,詳細講解了三範式取捨、慢查詢定位流程、測試數據構建、EXPLAIN 逐欄判讀。下一篇將深入:索引設計原則(最左前綴、覆蓋索引、索引下推)、JOIN 優化算法、配置參數模板、架構級讀寫分離與分庫分表實戰。