接續《MySQL 性能優化基礎篇》,本文深入實戰層面,系統講解索引底層原理、適用場景判斷、四大索引類型區別、復合索引最左前綴原理、常用 SQL 優化模式、存儲引擎選型決策樹、數據類型精準選擇及表維護操作,為開發者提供可直接落地的優化工具箱。
無需加內存、改程序、調 SQL,僅執行正確的 CREATE INDEX,查詢速度可能提升百倍千倍。但**代價是寫操作 (INSERT/UPDATE/DELETE) 額外 I/O 開銷**。
| 場景 | 建議 | 示例 |
|---|---|---|
| 頻繁作 WHERE 條件 | ✅ 建索引 | WHERE empno = 1 |
| 唯一性極差 (如性別) | ❌ 單列索引無效 | WHERE sex = '男' (掃描半表) |
| 極高頻更新列 | ❌ 避免建索引 | WHERE logincount = 1 (維護開銷大) |
| 從不出現在 WHERE | ❌ 無需建索引 | 純展示字段 |
| 類型 | 關鍵字 | 特點 | 適用場景 |
|---|---|---|---|
| 主鍵索引 | PRIMARY KEY | 唯一、非空、聚簇索引 (InnoDB) | 每張表必須、核心業務鍵 |
| 唯一索引 | UNIQUE | 值唯一、允許一個 NULL | 業務唯一約束 (郵箱、身份證) |
| 普通索引 | INDEX / KEY | 允許重複、允許 NULL | 常規查詢加速 |
| 全文索引 | FULLTEXT | 僅 MyISAM 支持 (5.6+ InnoDB 支持)、分詞搜索 | 英文全文檢索、中文需配合 Sphinx/Coreseek |
CREATE INDEX idx_name ON table(col1, col2);
WHERE col1 = ? ✅ 用到 | WHERE col2 = ? ❌ 不用WHERE col1 = ? AND col2 = ? ✅ 完整匹配WHERE col1 = ? AND col2 > ? ✅ col1 用到,col2 為範圍查詢,索引用到 col1-- 建表
CREATE TABLE dept(
deptno MEDIUMINT UNSIGNED NOT NULL DEFAULT 0,
dname VARCHAR(20) NOT NULL DEFAULT "",
loc VARCHAR(13) NOT NULL DEFAULT ""
) ENGINE=MyISAM DEFAULT CHARSET=utf8;
-- 1. 主鍵索引
ALTER TABLE dept ADD PRIMARY KEY (deptno);
EXPLAIN SELECT * FROM dept WHERE deptno=1;
-- type=const, key=PRIMARY, rows=1 ✅
-- 2. 復合索引
ALTER TABLE dept ADD INDEX myind (dname, loc);
EXPLAIN SELECT * FROM dept WHERE dname='研發部'; -- ✅ 用到 myind
EXPLAIN SELECT * FROM dept WHERE loc='MsBDpMRX'; -- ❌ 未用到
-- 3. LIKE 查詢
EXPLAIN SELECT * FROM dept WHERE dname LIKE '%研發部'; -- ❌ 未用到
EXPLAIN SELECT * FROM dept WHERE dname LIKE '研發部%'; -- ✅ 用到
-- 4. OR 條件殺死索引
ALTER TABLE dept DROP INDEX myind;
ALTER TABLE dept ADD INDEX myind (dname);
EXPLAIN SELECT * FROM dept WHERE dname='研發部' OR loc='aa'; -- ❌ 全表掃描
-- 5. 字符串隱式轉換
SELECT * FROM dept WHERE dname=1234; -- ❌ 未用到 (數字比較字符串)
SELECT * FROM dept WHERE dname='1234'; -- ✅ 用到
SHOW STATUS LIKE 'Handler_read%';
-- Handler_read_key: 越高越好 (索引查詢次數)
-- Handler_read_rnd_next: 越高越差 (全表掃描次數)
ALTER TABLE t DISABLE KEYS; INSERT...; ALTER TABLE t ENABLE KEYS; (關閉索引維護)SET unique_checks=0; ③ SET autocommit=0; (批量提交)SELECT * FROM dept GROUP BY dname ORDER BY NULL; (Extra 無 Using filesort)EXPLAIN SELECT * FROM emp, dept WHERE emp.deptno=dept.deptno; vs EXPLAIN SELECT * FROM emp LEFT JOIN dept ON emp.deptno=dept.deptno; 對比IN():phone='159' OR phone='136' → phone IN ('159','136') (IN 為 logN 級,建議值 ≤ 200)UNION:phone='159' OR name='john' → 兩條 SELECT 做 UNION (MySQL 索引合併弱)LIMIT 10000, 10 → WHERE id > 10000 LIMIT 10 (需主鍵/唯一索引有序)LOAD DATA 比 INSERT 快 ~20 倍| 場景 | 推薦引擎 | 理由 |
|---|---|---|
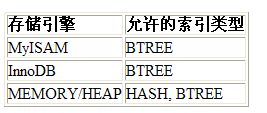
| 追求極致速度、數據可丟失、無事務需求 | MEMORY (HEAP) | 全內存、哈希索引、重啟數據丟失 |
| 數據持久化、讀/寫多、少更新刪除、弱事務需求 | MyISAM | 讀快、插入快、不支持事務/行鎖/外鍵、崩潰不安全 |
| 數據持久化、強事務(ACID)、高併發、行級鎖、外鍵 | InnoDB | 事務安全、崩潰恢復、MVCC、行鎖、聚簇索引、**生產首選** |
DECIMAL,**禁用 FLOAT/DOUBLE** (二進制浮點數有精度誤差)
CREATE TABLE t(t1 FLOAT(10,2), t2 DECIMAL(10,2));
INSERT INTO t VALUES(1000000.32, 1000000.32);
-- FLOAT 變 1000000.31, DECIMAL 精確
DATE (3B) - 僅日期DATETIME (8B) - 日期時間、大范圍、無時區TIMESTAMP (4B) - 日期時間、帶時區、自動初始化/更新、2038 年問題OPTIMIZE TABLE table_name; (刪除/更新頻繁表必做)
CREATE TABLE t2(id INT) ENGINE=MyISAM;
INSERT... DELETE... 發現 .MYD 文件未縮小
OPTIMIZE TABLE t2;  -- 文件大小縮小,碎片整理完成
ibdata1 或獨立表空間 (innodb_file_per_table=1 下每表一個 .ibd),數據目錄下僅 .frm 結構文件。MySQL 優化遵循「索引優先、SQL 重構、引擎匹配、類型精準、維護及時」原則。掌握 B+Tree 原理與最左前綴,識別索引失效模式 (OR、隱式轉換、%前導、範圍列後列);善用 EXPLAIN 與 Handler_read 監控驗證優化效果;根據業務屬性果斷選型引擎;嚴禁浮點數存金額;建立碎片整理例行機制。這些實戰技能將直接轉化為系統吞吐量提升與穩定性保障。