Sphinx 是高性能全文檢索引擎,支援 SQL/XML 數據源、分佈式擴展、毫秒級查詢。本文系統講解架構流程、核心配置、倒排索引原理、一元與 mmseg 分詞算法,並給出生產級配置範例。
| 場景 | MySQL LIKE | Sphinx |
|---|---|---|
| 跨庫/跨機房搜尋 | 網絡開銷大、全掃描慢 | 集中索引、內存查詢、無 I/O 瓶頸 |
| 多條件 WHERE + LIMIT | 索引選擇性差、filesort 慢 | 屬性過濾、固定內存排序、極快 |
| GROUP BY 聚合 | 臨時表、磁盤排序 | 固定內存分組、效率更高 |
| 多結果集並行 | 多次查詢或臨時表 | Multi-Query 一次批處理 |
| 分片數據聚合 | 應用層合併、慢 | 分布式索引、三行配置搞定 |
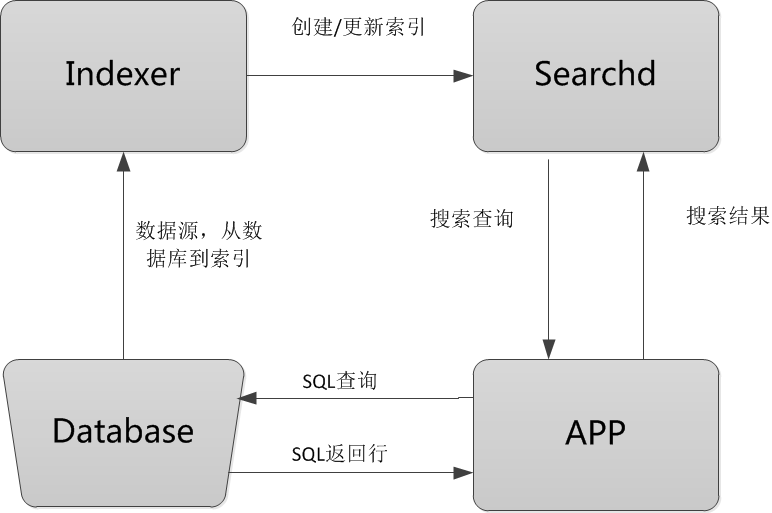
source test {
    type = mysql
    sql_host = 127.0.0.1
    sql_user = root
    sql_pass = root
    sql_db = test
    sql_port = 3306
    sql_query_pre = SET NAMES utf8
    sql_query = SELECT id, name, add_time FROM tbl_test
    sql_attr_timestamp = add_time
    sql_query_info_pre = SET NAMES utf8
    sql_query_info = SELECT * FROM tbl_test WHERE id=$id
}
index test_index {
    source = test
    path = /usr/local/coreseek/var/data/test
    docinfo = extern
    charset_dictpath = /usr/local/mmseg3/etc/
    charset_type = zh_cn.utf-8
    ngram_len = 1
    ngram_chars = U+3000..U+2FA1F
}
一元分詞(覆蓋率高、索引大、更新慢):
charset_type = utf8
ngram_len = 1
ngram_chars = U+3000..U+2FA1F
mmseg 分詞(統計模型、語義準確、需詞典):
charset_type = utf8
charset_dictpath = /usr/local/mmseg3/etc/
ngram_len = 0
定義:詞 → 文檔 ID 映射(傳統索引是 ID → 文檔)。
兩大組件:
1. 單詞詞典:所有詞條 + 指向倒排列表的指針(Hash/Trie/B-Tree)
2. 倒排文件:每個詞的文檔 ID 列表(倒排列表),含詞頻、位置等
關鍵概念:
Chunk:一句話的某種分詞方式(詞條數組 + 四規則評分)
例:「研究生命」→ [研究, 生命] vs [研究生, 命] 兩個 Chunk
四規則歧義消解(優先級遞減):
四規則後仍有多解 → 需自定義擴展。
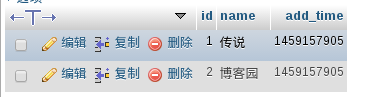
數據:
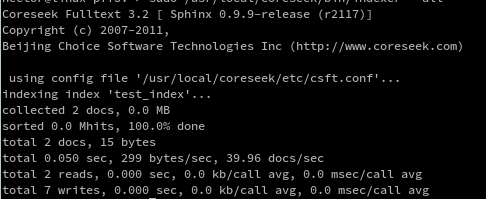
建索引:
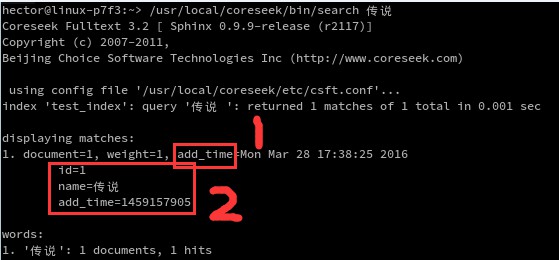
查詢:
indexer --rotate 增量重建,或用 realtime index (RT 索引)distributed_index 聚合多分片uni.lib、自定義詞典searchd --status、查詢 QPS、延遲、索引大小