MySQL 字符集設置點多、鏈路長,亂碼本質是「錯誤的編碼被當作正確編碼解析」。本文通過流程圖、抓包案例、五個思考題,徹底講透 character_set_client/connection/results/database/server 交互邏輯。
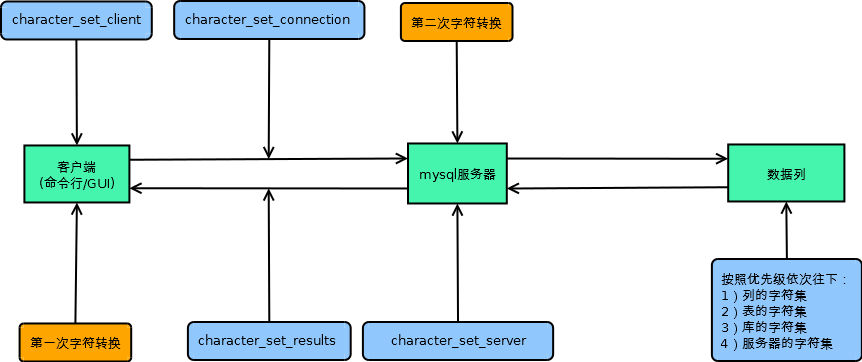
character_set_client)接收用戶輸入character_set_connection) → **第一次轉換**character_set_results)轉換 → **逆向第一次**character_set_client 轉換 → **逆向第二次**character_set_client = latin1 character_set_connection = latin1 character_set_database = utf8 character_set_results = latin1 character_set_server = utf8
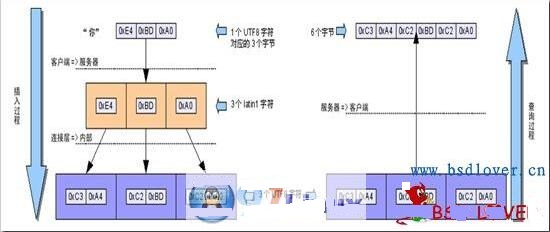
插入中文「你」(UTF-8: E4 BD A0),觀察五個階段數據包變化。
| # | 現象 | 核心解釋 |
|---|---|---|
| 1 | 客戶端/連接 latin1,發包卻是正確 UTF-8 | 輸入源是 UTF-8 文本,latin1 單字節直通,二進制未變,MySQL 以為是 3 個 latin1 字符 |
| 2 | latin1 接收包仍是正確 UTF-8 | 服務端將列存儲的「偽 UTF-8」(實為 latin1 解讀的 6 字節)轉 latin1,恰好還原為 3 字節 UTF-8 |
| 3 | latin1 顯示正確中文 | 客戶端收到 3 字節 latin1,拋給 SecureCRT,終端按 UTF-8 渲染,剛好對上 |
| 4 | 連接/庫同為 UTF-8,接收包反不是 UTF-8 | 全鏈路無轉換,直接返回存儲的「偽 UTF-8」(6 字節) |
| 5 | 連接/庫同為 UTF-8,顯示亂碼 | 終端收到 6 字節,按 UTF-8 解析為 2 個字符,非預期中文 |
字符變化圖解:
SHOW VARIABLES LIKE '%char%';
-- 關鍵變量:
-- character_set_client     客戶端編碼
-- character_set_connection 連接編碼
-- character_set_results    結果集編碼
-- character_set_database   庫默認編碼
-- character_set_server     服務端默認編碼
SET NAMES utf8mb4)CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci-- 一鍵設定三大連接變量 SET NAMES utf8mb4; -- 查看表/列實際字符集 SHOW CREATE TABLE t; SELECT COLUMN_NAME, CHARACTER_SET_NAME FROM INFORMATION_SCHEMA.COLUMNS WHERE TABLE_SCHEMA='db' AND TABLE_NAME='t';