高可用是互聯網服務標配,數據庫層更需兼顧可用性與數據一致性。本文系統總結主流 MySQL 高可用方案,按底層技術分類,分析優缺點與適用場景。
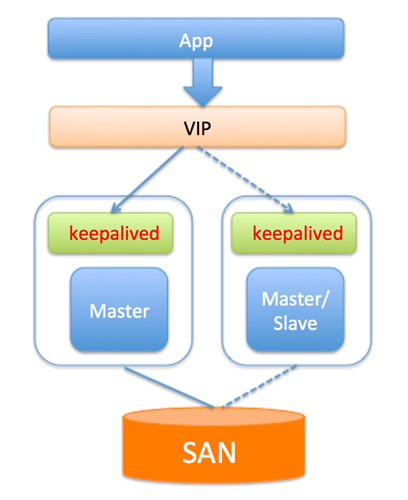
原理: 通過存儲區域網絡實現多服務器共享同一存儲,主庫故障時備庫掛載同一文件系統接管服務。
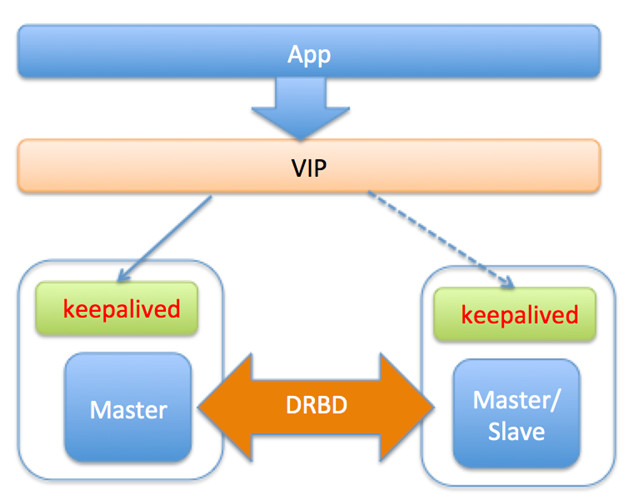
原理: Linux 內核模塊實現塊級同步複製,將主庫寫入同步至備庫磁盤,類似網絡級 RAID1。
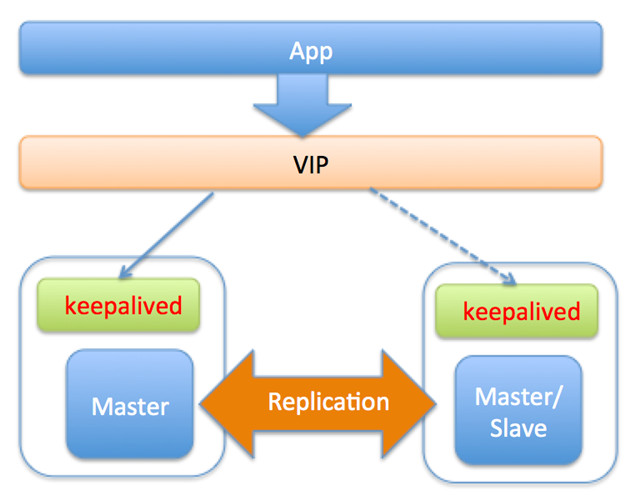
生產環境主流方案,利用 MySQL 內建複製構建熱備,主庫故障時切換至從庫。按自動化程度分級:
架構: 主從各裝 Keepalived,配置虛擬 IP (VIP),應用訪問 VIP。主庫故障時 VIP 漂移至從庫。
原理: Perl 開發,由 Manager 節點監控集群,故障時從宕機主庫抓取 binlog 補償,選最新從庫提升為新主,重建複製鏈路。
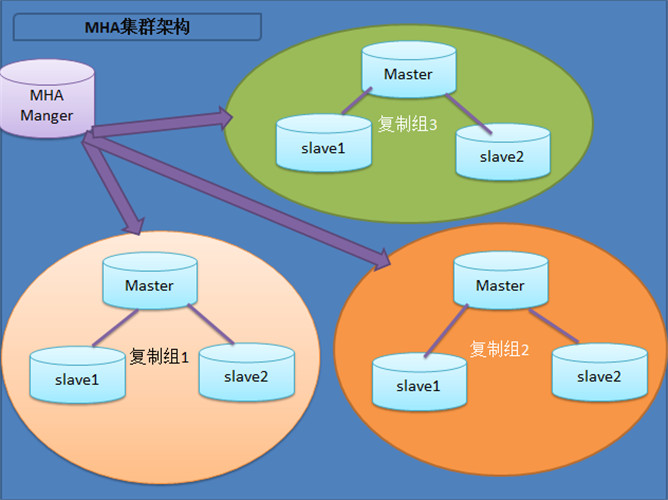
Failover 流程: 檢測故障 → 判斷拓撲 → 處理舊主 → 比較位點選新主 → 補充 binlog/relaylog → 新主上線 → 其他從庫重新指向。
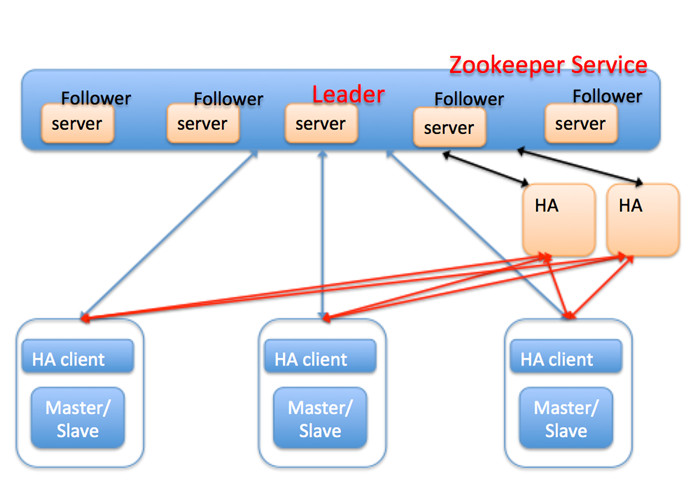
核心思想: 引入分布式一致性協議解決 HA 軟件自身單點。各 MySQL 節點部署 HA Client 向 ZooKeeper 上報心跳;HA 節點監聽 ZooKeeper 事件,通過分布式鎖協調切換動作,避免腦裂。
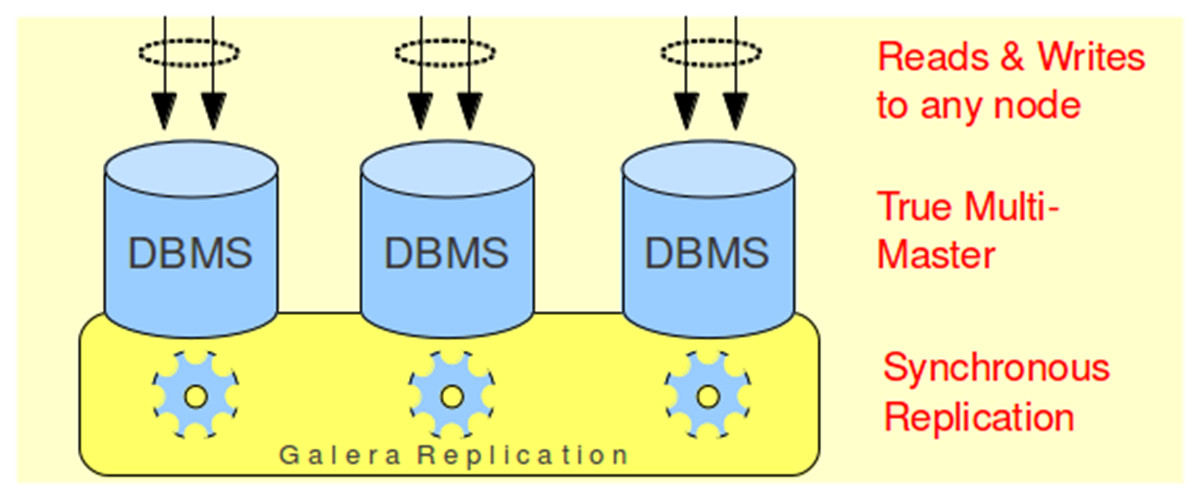
基於 Galera 庫,InnoDB 引擎,準同步複製,多節點可讀寫。
基於 NDB 存儲引擎,特性類似但限制較多,生產較少見。
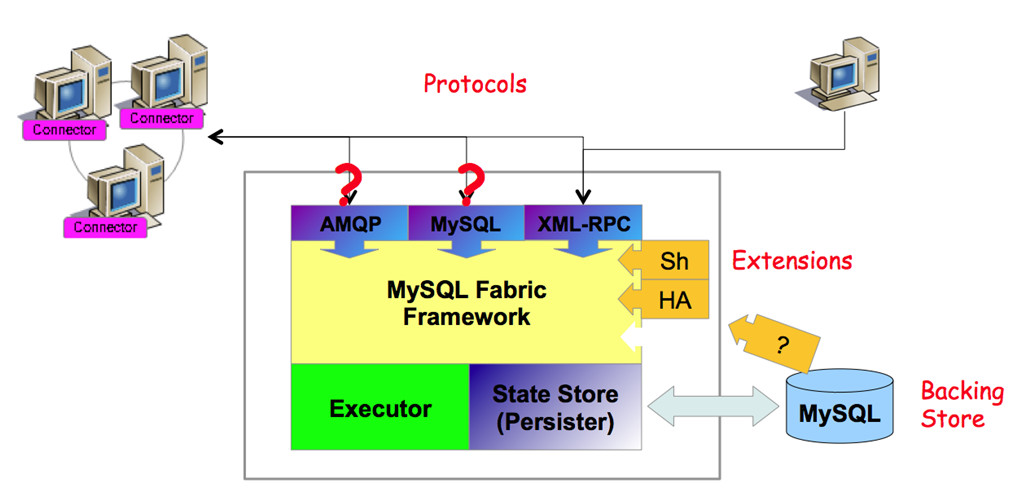
如 MySQL Fabric、Cobar、TDDL。應用連接 Proxy,Proxy 感知後端拓撲,故障自動路由至新主,實現對應用完全透明,並支援分片擴展。
| 方案 | 適用場景 | 複雜度 | 一致性 | 擴展性 |
|---|---|---|---|---|
| SAN/DRBD | 傳統企業應用、強一致要求高、預算充足 | 低 | 強 | 差 |
| Keepalived | 中小規模、可容忍秒級數據丟失、運維資源有限 | 低 | 弱(異步)/中(半同步) | 中 |
| MHA | 中大型、需自動故障轉移、減少數據丟失 | 中 | 中(半同步+補償) | 中 |
| ZooKeeper HA | 大規模集群、極高可用要求、有運維團隊 | 高 | 可配置強 | 極強 |
| PXC | 需寫擴展、強一致、單機房、InnoDB-only | 中高 | 強 | 中(受網絡限制) |
| Proxy中間件 | 微服務架構、需分片、跨機房、開發資源豐富 | 高 | 中 | 極強 |
選型核心:業務場景決定架構。小團隊優先 Keepalived/MHA;大規模、強一致、寫擴展需求看 PXC 或 Proxy+ZooKeeper;預算足且追求極簡運維可考慮 SAN。無銀彈,權衡取捨。