GROUP BY 本質上包含排序與分組,同樣可利用索引加速。MySQL 優化器提供三種實現路徑:
定義:僅掃描索引中滿足分組條件的「首個鍵值」,無需遍歷所有滿足 WHERE 的索引鍵。
適用條件:
GROUP BY 字段為同一索引最左連續前綴(如 idx(a,b,c) 支援 GROUP BY a 或 GROUP BY a,b)MAX()/MIN() 且指向同一列EXPLAIN 特徵:Extra: Using index for group-by
範例:
CREATE INDEX idx_gid_uid_gc ON group_message(group_id, user_id, gmt_create);
EXPLAIN SELECT user_id, MAX(gmt_create)
FROM group_message
WHERE group_id < 10
GROUP BY group_id, user_id;
-- Extra: Using where; Using index for group-by
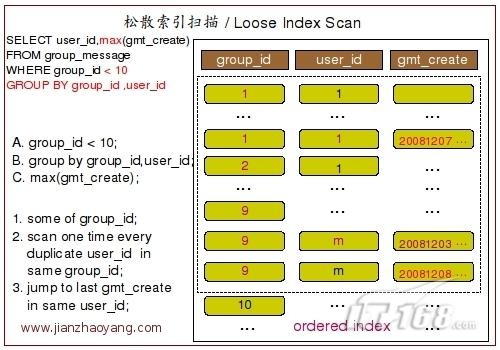
效率來源:無 WHERE 時讀取鍵值數 = 分組數;有範圍條件時僅定位各組首鍵,跳過中間鍵值。
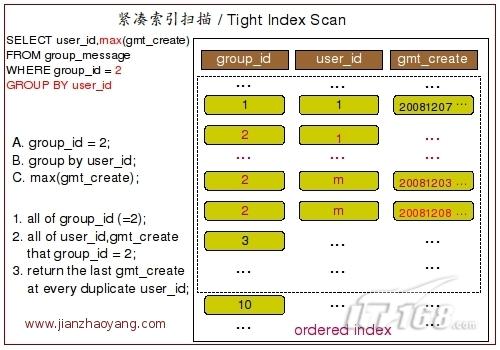
定義:需掃描 WHERE 條件限定範圍內的所有索引鍵,再分組聚合。
觸發場景:GROUP BY 字段不連續或非索引前綴,但 WHERE 提供常量填補「間隙」形成完整前綴。
EXPLAIN 特徵:Using where; Using index(無 for group-by)
範例:
EXPLAIN SELECT MAX(gmt_create)
FROM group_message
WHERE group_id = 2
GROUP BY user_id;
-- 索引 idx(group_id, user_id, gmt_create)
-- group_id 常量填補前綴,緊湊掃描 group_id=2 所有鍵
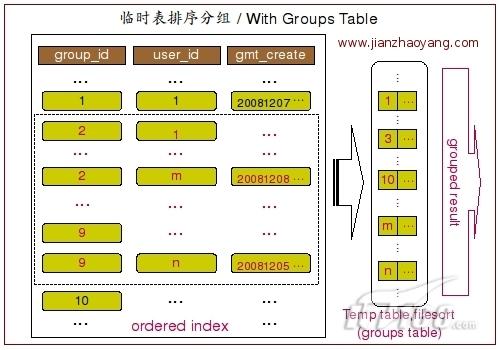
觸發條件:無可用索引滿足分組順序(如 GROUP BY 字段不在同一索引、使用 Hash 索引、聚合函數非 MAX/MIN)。
EXPLAIN 特徵:Using temporary; Using filesort
範例:
EXPLAIN SELECT MAX(gmt_create)
FROM group_message
WHERE group_id BETWEEN 1 AND 9
GROUP BY user_id;
-- group_id 範圍非常量,user_id 非索引前綴 → 臨時表
sort_buffer_size 足夠大、避免大結果集、防止 tmp_table_size 溢出落盤DISTINCT 原理同 GROUP BY,同樣可用鬆散索引。