業務常需發現「庫存相同」「手機號重複」「訂單號重複」等異常數據。本文給出標準 SQL 查重模板、解釋執行原理,並提供大表優化、多字段組合查重、刪除重複保留一條等進階技巧。
SELECT * FROM table_name
WHERE column_name IN (
    SELECT column_name
    FROM table_name
    GROUP BY column_name
    HAVING COUNT(*) > 1
);
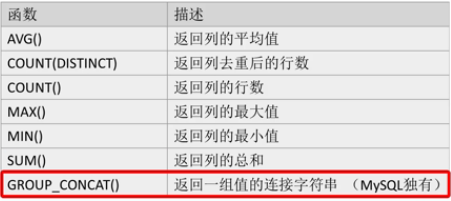
執行邏輯:子查詢先按 column_name 分組聚合,HAVING COUNT(*) > 1 篩選出現次數 > 1 的值集合;外層查詢回表獲取所有包含這些值的完整行。
場景 優化寫法 原理 百萬級以上表 -- 使用 JOIN 替代 IN 子查詢 SELECT t1.* FROM goods t1 JOIN ( SELECT inventory FROM goods GROUP BY inventory HAVING COUNT(*) > 1 ) t2 USING (inventary);Derived Table 可利用索引/哈希連接,避免 IN 子查詢在 5.6 前的物化/掃描效能問題 需統計重複次數 單次掃描聚合,直接輸出重複值、次數、關聯主鍵,無需回表 高頻查重需秒級響應 在 inventory建立普通索引索引掃描替代全表掃描,分組聚合走 Index Full Scan 分區表 確保分區鍵包含查重字段,或全表掃描所有分區 分區裁剪生效需分區鍵出現在 WHERE/GROUP BY 中 多字段組合查重(業務主鍵去重)
-- 保留 id 最小的一條(MySQL 不支持直接 JOIN DELETE 同表,用多表 DELETE 語法) DELETE t1 FROM goods t1 JOIN ( SELECT inventory, MIN(id) AS keep_id FROM goods GROUP BY inventory HAVING COUNT(*) > 1 ) t2 ON t1.inventory = t2.inventory AND t1.id > t2.keep_id; -- 保留 id 最大的一條 DELETE t1 FROM goods t1 JOIN ( SELECT inventory, MAX(id) AS keep_id FROM goods GROUP BY inventory HAVING COUNT(*) > 1 ) t2 ON t1.inventory = t2.inventory AND t1.id < t2.keep_id;窗口函數寫法