當單表資料量達到百萬、千萬級,常見優化手段是水平分表:依主鍵範圍、時間欄位或業務條件,將資料拆分到多張同結構表,甚至分散到不同 MySQL 實例(Sharding)。但隨之而來的難題是:跨分片的批量查詢如何高效聚合?
本文提出應用層面的並行查詢管理器模式,並說明 JDBC 攔截與 MySQL 5.1 Partition 的差異。
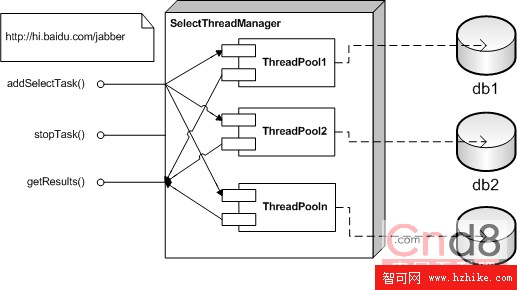
addTask()、stopTask()、getResult()。addTask() 將新 Thread 排入 Pool N 隊列。stopTask() 設定所有相關 Thread 的停止旗標,並返回部分結果或報錯。此機制避免單一熱點分片拖垮整體查詢響應,實現「快速失敗」與資源隔離。
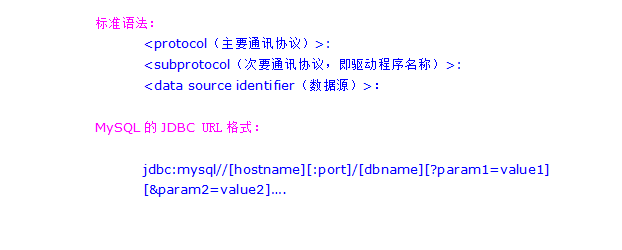
為了不侵入業務代碼,可封裝一個 JDBC Driver Wrapper,攔截 PreparedStatement、Statement 的 executeQuery(),解析 SQL 中的分片鍵,自動路由到 SelectThreadManager 執行並聚合結果。對上層應用完全透明,僅需更換 JDBC URL 與 Driver 類名。
| 維度 | MySQL Partition | 手工分表 |
|---|---|---|
| 實現層級 | Server 內核 | 應用/中間件層 |
| 跨分區查詢 | 內部並行掃描,對調用者透明 | 需外部協調聚合 |
| IO 瓶頸 | 可將數據分散到多磁碟/分區緩解 | 可分散到多實例/多機器徹底解決 |
| CPU 計算瓶頸 | 無法解決(單線程執行計劃) | 可透過多實例並行計算水平擴展 |
| 運維複雜度 | 低(單表管理) | 高(需管理路由、DDL 變更、再平衡) |
結論:Partition 僅解決 IO 層面的單表過大問題,無法利用多核 CPU 並行計算。對於高併發、大數據量的 OLAP 或複雜 OLTP 場景,手工分表 + 應用層並行查詢管理器仍是更強的架構選擇。