在 MySQL 中對中文數據做 LIKE '%a%' 模糊查詢時,常出現「明明沒有字母 a 卻被匹配出來」的誤判。根因是字符集校對規則導致多字節中文字符被拆解為單字節比較。本文從原理到實戰,給出 BINARY + UCASE 組合拳徹底解決。
-- 查找標題含 'a' 的新聞
SELECT id, title, name FROM news WHERE title LIKE '%a%';
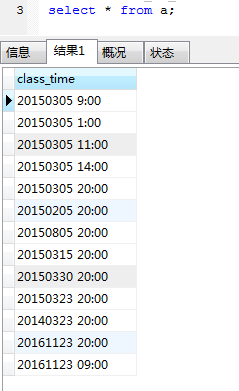
-- 結果混雜:既有真正含 'a' 的,也有純中文標題(如「測試」)utf8_general_ci、gbk_chinese_ci)為大小寫不敏感、按字符權重比較。SELECT id, title, name FROM news WHERE BINARY title LIKE '%a%';✅ 精確匹配字節,誤判消失。
❌ 區分大小寫,'Achech' 與 'achech' 結果不同。
-- 推薦寫法:參數化友好,無需調用端拼接 %
SELECT id, title, name
FROM news
WHERE BINARY UCASE(title) LIKE CONCAT('%', UCASE('a'), '%');

-- 等價簡寫(需確保參數已含 %)
SELECT id, title, name
FROM news
WHERE BINARY UCASE(title) LIKE UCASE('%a%');執行流程:
UCASE(title) 將列值轉大寫(中文不變)。UCASE('a') 將搜索詞轉大寫。CONCAT('%', ..., '%') 動態生成模式。BINARY 強制按字節精確比較。BINARY、函數包裹列會導致無法使用普通索引,全表掃描。FULLTEXT + MATCH ... AGAINST),MySQL 5.7+ 原生支持中文分詞(ngram parser)。CHARSET utf8mb4 COLLATE utf8mb4_0900_ai_ci(MySQL 8.0 默認),減少校對歧義。UCASE。BINARY UCASE ... LIKE CONCAT('%', UCASE(?), '%'),簡單可靠。掌握 BINARY + UCASE + CONCAT 組合拳,能在不改架構前提下快速修復中文模糊查詢誤判,為後續架構升級贏得時間窗口。