在資料庫開發中,對查詢結果進行排序並生成排名是常見需求。本文透過實際測試表,示範兩種在 SQL 中實現數據排名的經典方法,幫助你根據場景選擇最優方案。
首先建立測試表並插入樣本數據:
-- 建立測試表
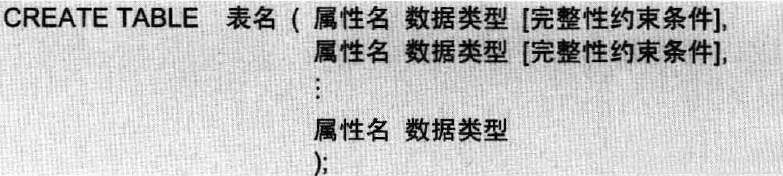
CREATE TABLE Test(F1 char(10), F2 char(10));

-- 插入測試數據
INSERT INTO Test
SELECT 'a' F1, '1' F2 UNION
SELECT 'b' F1, '2' F2 UNION
SELECT 'c' F1, '4' F2 UNION
SELECT 'd' F1, '3' F2 UNION
SELECT 'e' F1, '4' F2 UNION
SELECT 'f' F1, '5' F2 UNION
SELECT 'g' F1, '4' F2 UNION
SELECT 'h' F1, '7' F2 UNION
SELECT 'i' F1, '9' F2;利用相關子查詢統計比當前行 F2 值大的記錄數,加 1 即為排名:
SELECT a.*,
       (SELECT COUNT(*) FROM test b WHERE b.F2 > a.F2) + 1 AS minci
FROM test a
ORDER BY minci;優點:邏輯直觀,語法簡單,適合中小數據量。
缺點:大數據量時子查詢會重複掃描表,性能較差。
先按 F2 降序將數據導入帶身份列的臨時表,再通過分組運算修正並列值相同的排名:
-- 建立帶身份列的臨時表
SELECT id = IDENTITY(int, 0, 1), f1, f2 INTO #t FROM test ORDER BY F2 DESC;

-- 計算排名
SELECT a.f1, a.f2,
       a.id + 1 - CAST(id - cc - minn AS char(10)) AS [名次]
FROM #t a,
     (SELECT f2, cc, minn
      FROM (SELECT f2, COUNT(*) AS cc, MIN(id) - COUNT(*) AS minn
            FROM #t GROUP BY f2) t) b
WHERE a.f2 = b.f2
ORDER BY a.f2 DESC;

-- 清理臨時表
DROP TABLE #t;
DROP TABLE test;優點:單次掃描配合分組運算,大數據量下效率顯著優於方法一。
注意:需確保臨時表建立時的排序與最終排名邏輯一致。
掌握這兩種經典思路,有助於理解排名邏輯的本質,在不支持窗口函數的舊版本環境中也能遊刃有餘。