優化口訣:「該建必建、精準前綴、覆蓋優先、拒絕過度」
| # | 原則 | 關鍵動作 | 反模式 |
|---|---|---|---|
| 1 | 用索引加速遍歷 | 高選擇性列建索引;範圍查詢/排序/分組列考慮聚簇索引 | 全表掃描成常態 |
| 2 | 組合索引最左前綴 | WHERE/Order By/Group By 列順序與索引列順序一致 | 索引列順序顛倒導致失效 |
| 3 | 覆蓋索引避免回表 | SELECT 列 ⊆ 索引列,Extra=Using index | SELECT * 強制回表 |
| 4 | 列運算殺死索引 | WHERE col + 1 = 10 → WHERE col = 9 | 函數/運算/隱式轉換包裹索引列 |
| 5 | IN/OR 謹慎使用 | IN 值集小可用;OR 改 UNION ALL + 索引 | 大 IN 列表 / OR 跨列無索引 |
| 6 | 小類型大智慧 | MEDIUMINT 代替 INT;NOT NULL 默認;ENUM 代替 VARCHAR 低基數 | BIGINT 存布爾/狀態碼 |
| 7 | 拒絕 VARCHAR/TEXT/BLOB 當主鍵/索引前綴過長 | 主鍵用自增 BIGINT/UUID_SHORT;前綴索引長度夠區分即可 | VARCHAR(255) 主鍵 + 全長索引 |
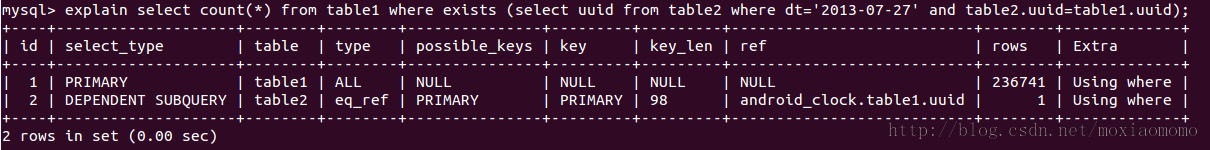
| 8 | EXPLAIN 驗證每條慢查詢 | 關注 type、key、rows、Extra (Using filesort/temporary) | 裸跑上線再看慢查詢日志 |
| 9 | 多表 JOIN 索引策略 | 驅動表小、被驅動表 JOIN 列有索引;Redundant 索引清理 | 大表驅動小表、被驅動表無索引 |
| 10 | 索引維護成本核算 | 寫多讀少表減少索引;批量導入先 Drop Index 後重建 | 單表 20+ 索引,INSERT 狂慢 |
| 11 | 前綴索引長度科學計算 | SELECT COUNT(DISTINCT LEFT(col, N))/COUNT(*) 從 0.9 起步 | 隨意索引前 10 字符 |
| 12 | 慢查詢日志 + pt-query-digest 定期複盤 | 長期觀察 Top 10 慢查詢,針對性優化 | 只看當下不看趨勢 |
-- 無索引
SELECT * FROM users WHERE username LIKE '%許%';  -- 0.54s 平均
SELECT * FROM users WHERE username LIKE '許%';   -- 0.53s 平均
SELECT * FROM users WHERE username LIKE '%許';   -- 0.51s 平均

-- 建立前綴索引 (username 前 6 字符)
CREATE INDEX idx_username_prefix ON users(username(6));

-- 有索引
SELECT * FROM users WHERE username LIKE '%許%';  -- 0.34s (提升 37%)
SELECT * FROM users WHERE username LIKE '許%';   -- 0.065s (提升 88% !!!)
SELECT * FROM users WHERE username LIKE '%許';   -- 0.31s (提升 39%)
結論:前綴索引對 **左前綴匹配 (`LIKE 'prefix%'`)** 提升毀滅性;對 `%中間%`、`%後綴` 提升有限,需全文索引或架構調整 (如 Elasticsearch)。
-- 場景:訂單 100萬 + 用戶 10萬,查詢某用戶最近 20 條訂單
-- 錯誤:orders 無 user_id 索引
EXPLAIN SELECT * FROM orders o JOIN users u ON o.user_id = u.id WHERE u.id = 1001 ORDER BY o.created_at DESC LIMIT 20;
-- type=ALL, rows=1000000

-- 正確:orders(user_id, created_at) 組合索引
CREATE INDEX idx_orders_user_created ON orders(user_id, created_at);
-- type=ref, rows=20 (索引下推 + 排序已滿足)
SQL 優化無銀彈,**「EXPLAIN 驗證假設 → 最小化掃描行數 → 平衡讀寫成本」** 是唯一科學路徑。將 12 條原則印成卡片貼在工位,每次寫慢查詢前過一遍,半年內必成優化高手。