| 類型 | 關鍵字 | 約束 | 適用場景 | 創建語法 |
|---|---|---|---|---|
| 普通索引 | INDEX / KEY | 無 | 一般查詢加速 | CREATE INDEX idx_name ON t(col) |
| 唯一索引 | UNIQUE | 值唯一 (允許多 NULL) | 業務鍵 (email、手機號) | CREATE UNIQUE INDEX uk_email ON t(email) |
| 主鍵 | PRIMARY KEY | 唯一 + NOT NULL、聚簇索引 | 表標識、InnoDB 必須有 | PRIMARY KEY (id) |
| 全文索引 | FULLTEXT | 支援自然語言/布爾模式搜索 | 長文本搜索、日誌分析 | CREATE FULLTEXT INDEX ft_content ON t(content) |
| 空間索引 | SPATIAL | GIS 幾何類型 | 地理位置查詢 | CREATE SPATIAL INDEX sp_geo ON t(geo) |
WHERE firstname='Mike' AND lastname='Sullivan' AND age=17複合索引 (a, b, c) 可滿足:
WHERE a=1 AND b=2 AND c=3 ✅WHERE a=1 AND b=2 ✅WHERE a=1 ✅WHERE b=2 ❌ (未用最左列 a)WHERE a=1 AND c=3 ⚠️ (用 a,c 無法用索引查找,僅過濾)ORDER BY a, b, c ✅ (避免 filesort)SELECT p.age, t.name
FROM people p
LEFT JOIN town t ON p.townid = t.townid
WHERE p.firstname='Mike' AND p.lastname='Sullivan';**必建索引**:
people(firstname, lastname) — WHERE 等值條件town(townid) — JOIN 關聯列 (被驅動表)people(townid) — 可選,若 town 很大且作驅動表**無需索引**:SELECT 列 (age, name) — 僅輸出,不參與過濾/連接/排序。
| 操作符 | 能否用索引 | 條件 |
|---|---|---|
=, <, >, <=, >=, BETWEEN, IN | ✅ | 常數在右側、列無運算 |
LIKE 'prefix%' | ✅ | 固定前綴,非通配符開頭 |
LIKE '%suffix' | ❌ | 導掃,除非反向索引/全文 |
IS NULL / IS NOT NULL | ✅ | 5.6+ 優化器可用 |
!=, <>, NOT IN | ❌ | 範圍過大,通常全掃 |
col + 1 = 2 / UPPER(col) = 'A' | ❌ | 列上有運算/函數,索引失效 (8.0 函數索引除外) |
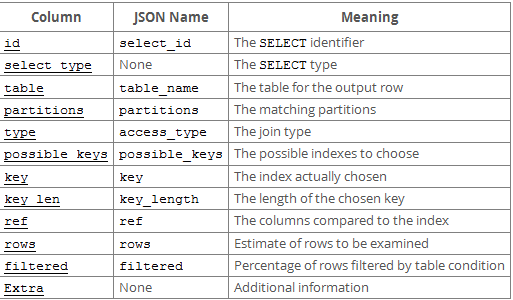
EXPLAIN SELECT peopleid FROM people
WHERE firstname='Mike' AND lastname='Sullivan' AND age=17;| 列 | 含義 | 優秀值 |
|---|---|---|
| type | 連接類型 | system/const/eq_ref/ref/range > index > ALL |
| possible_keys | 可能用到的索引 | 含目標索引名 |
| key | 實際用到的索引 | 非 NULL,名稱明確 |
| key_len | 索引使用長度 (字節) | 與預期列長度匹配 |
| ref | 比較值來源 | const/列名 |
| rows | 預估掃描行數 | 接近 1 (唯一) 或小數值 |
| Extra | 額外信息 | Using index (覆蓋) 好;Using filesort/Using temporary 差 |
ANALYZE TABLE**pt-query-digest 找出 Top SQLEXPLAIN 觀察 type/key/rows/ExtraANALYZE TABLE、監控 Innodb_buffer_pool_reads、Handler_read_rnd_next索引是關係型數據庫**性能杠杆**,但**不是銀彈**。**B+ 樹有序結構 + 最左前綴 + 覆蓋索引 + EXPLAIN 驗證** 是核心方法論。記住:**為查詢建索引,為寫入減索引,為業務找平衡**。大表索引變更必走 gh-ost/pt-online-schema-change 在線無鎖變更,嚴禁直接 ALTER TABLE 鎖表數小時。