前言:系統化排查慢查詢
慢查詢成因跨越應用、SQL、索引、架構、硬體、作業系統、網路七大層面。本文將 50 個成因歸類為 7 大維度,並提供對應優化對策與工具鏈。
一、索引與結構設計缺陷(最常見)
| # | 成因 | 對策 |
|---|
| 1 | 無索引或索引未命中 | EXPLAIN 分析,補建複合索引,遵循最左前綴 |
| 2 | 隱式類型轉換導致索引失效 | WHERE 欄位與參數類型一致,避免 VARCHAR 比數字 |
| 3 | 函數/運算作用於索引欄 | WHERE YEAR(dt)=2024 → WHERE dt >= '2024-01-01' AND dt < '2025-01-01' |
| 4 | LIKE 前置萬用字元 | 全文索引、Elasticsearch、或應用層前綴匹配 |
| 5 | OR 條件導致索引失效 | 改寫為 UNION ALL(各分支有索引)、或複合索引覆蓋 |
| 6 | 低選擇性欄位建單列索引 | 性別/狀態碼不建單列索引,併入複合索引或全表掃描更快 |
| 7 | 過度索引拖慢寫入 | 定期審視 sys.schema_unused_indexes 刪除無用索引 |
| 8 | 主鍵設計不當(UUID、非單調) | 自增整數/有序 UUID (COMB),避免頁分裂與叢集索引碎片 |
| 9 | 缺乏覆蓋索引導致回表 | 將 SELECT 欄位納入複合索引,實現 Index Only Scan |
| 10 | 外鍵鎖開銷大 | 高併發核心表移除 FK,應用層保證一致性 |
二、SQL 寫法與優化器限制
| # | 成因 | 對策 |
|---|
| 11 | SELECT * 產生大量網路/IO | 明確列出所需欄位 |
| 12 | 大結果集未分頁/限制 | 強制 LIMIT、游標分批、流式處理 |
| 13 | 不必要的 DISTINCT/ORDER BY | 應用層去重排序、或確認業務必要性 |
| 14 | UNION 去重開銷(UNION ALL 更快) | 確定無重複或允許重複時用 UNION ALL |
| 15 | 子查詢未優化為 JOIN(MySQL 5.6 前) | 升級 5.7+、或手動改寫 JOIN、使用 CTE (8.0) |
| 16 | 相關子查詢逐行執行 | 改寫為 JOIN、衍生表、或應用層多次查詢組裝 |
| 17 | IN 子查詢大量值 | 改用 JOIN、EXISTS、或臨時表/値列表 |
| 18 | 隱式字符集排序規則轉換 | 統一資料庫/表/欄/連線字符集 utf8mb4 |
| 19 | 分頁深翻頁 (LIMIT 100000, 20) | 延遲關聯:SELECT * FROM t JOIN (SELECT id FROM t LIMIT 100000, 20) tmp USING(id) |
| 20 | 優化器統計資訊過期 | ANALYZE TABLE、innodb_stats_persistent=ON、定時更新 |
三、鎖爭用與並發控制
| # | 成因 | 對策 |
|---|
| 21 | 行鎖升級為表鎖(無索引條件) | 確保 UPDATE/DELETE 有索引支援 |
| 22 | 長事務持有鎖時間過長 | 拆分小事務、避免事務中 RPC/HTTP 呼叫、innodb_lock_wait_timeout 設定合理 |
| 23 | 死鎖頻發 | 固定加鎖順序、縮短事務、SHOW ENGINE INNODB STATUS 分析死鎖日誌 |
| 24 | 間隙鎖/Next-Key Lock 過度鎖定 | RC 隔離級別減少間隙鎖、精確索引條件 |
| 25 | 熱點行高併發更新 | 應用層佇列化、樂觀鎖 (version)、分桶計數器 |
| 26 | Metadata Lock (MDL) 爭用 | 避免長查詢期間 DDL、8.0 即時 DDL、LOCK=NONE |
四、硬體與作業系統瓶頸
| # | 成因 | 對策/監控指標 |
|---|
| 27 | I/O 吞吐不足 | NVMe SSD、RAID 10、iostat -xmt 1 觀察 %util < 80%, await < 10ms |
| 28 | 記憶體不足導致 Swap | free -h, vmstat 1 觀察 si/so,innodb_buffer_pool_size 設 物理記憶體 70% |
| 29 | CPU 飽和 | mpstat -P ALL 1 觀察 %sys 高 = 系統調用/鎖開銷,優化 SQL 減少排序/聚合 |
| 30 | 網路延遲/頻寬限制 | 應用/資料庫同可用區、連線池複用、壓縮協議 |
| 31 | 檔案系統/磁碟排程器不當 | SSD 用 noop/none,HDD 用 deadline,關閉 atime |
| 32 | NUMA 架構記憶體跨節點存取 | numactl --interleave=all 啟動 mysqld、或關閉 NUMA |
五、MySQL 參數配置不當
| # | 關鍵參數 | 常見誤區 | 建議值 |
|---|
| 33 | innodb_buffer_pool_size | 預設 128M 極小 | 專用機 70-80% 物理記憶體 |
| 34 | innodb_log_file_size | 預設 48M 太小,導致頻繁 checkpoint | 1-4GB,配合 innodb_log_files_in_group |
| 35 | innodb_flush_log_at_trx_commit | 設 0/2 風險丟數據 | 核心業務 1,非核心 2 |
| 36 | sync_binlog | 設 0 風險丟 Binlog | 1(配合電池備援 RAID 卡可放寬) |
| 37 | max_connections | 過大導致記憶體 OOM | 配合 Thread Pool,實際並發 + 余量 |
| 38 | query_cache_size | 開啟反而拖慢(5.7 已移除) | 0(關閉),改用 Redis |
| 39 | tmp_table_size / max_heap_table_size | 太小導致臨時表落地磁碟 | 64M-256M,觀察 Created_tmp_disk_tables |
| 40 | sort_buffer_size / join_buffer_size | 按連線分配,設太大 OOM | 256K-2M,複雜排序/Join 會話級 SET 臨時加大 |
六、架構與高可用設計缺陷
| # | 成因 | 對策 |
|---|
| 41 | 單點資料庫無高可用 | MHA/Orchestrator/Galera/Group Replication 自動故障轉移 |
| 42 | 主從延遲導致讀舊數據 | 半同步複寫、GTID、關鍵讀走主庫、ProxySQL 讀寫分離 |
| 43 | 大表未分庫分表 | 水平分表 (Sharding)、垂直拆庫、中間件 |
| 44 | 冷熱資料未分離 | 歸檔歷史資料、分區表、Tiered Storage |
| 45 | 備份策略缺失/未驗證 | XtraBackup 全量+增量、定期恢復演練、RPO/RTO 量化 |
七、應用層與運維盲區
| # | 成因 | 對策 |
|---|
| 46 | 連線池洩漏/配置不當 | HikariCP/Druid 監控活躍/閒置連線、maxLifetime < wait_timeout |
| 47 | N+1 查詢問題 (ORM 典型) | 批量載入、JOIN FETCH、EntityGraph、查詢計畫快取 |
| 48 | 無慢查詢監控告警 | pt-query-digest 定時分析、Prometheus + Grafana 告警 |
| 49 | 統計資訊未自動更新 | innodb_stats_auto_recalc=ON、大表定時 ANALYZE |
| 50 | 變更無回滾預案 | 所有 DML/DDL 先備份、pt-online-schema-change 可中斷回滾 |
系統化排查工具鏈
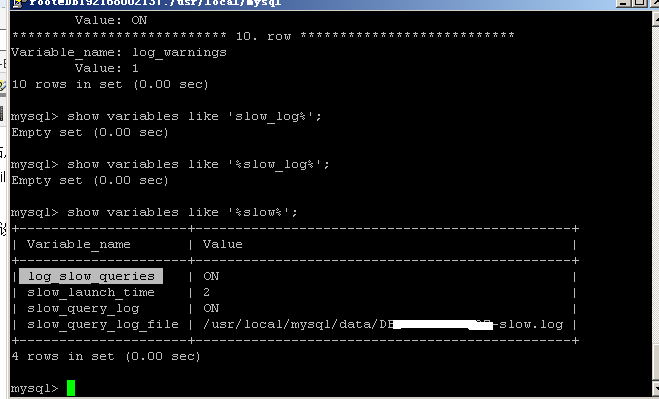
- 發現:慢查詢日誌 +
long_query_time=0 (全採樣) → pt-query-digest Top 10。
- 定位:
EXPLAIN ANALYZE (8.0.18+) / EXPLAIN FORMAT=JSON / OPTIMIZER_TRACE。
- 驗證:
SHOW STATUS (Handler_*)、performance_schema (events_statements_history_long)。
- 優化:加索引 → 改 SQL → 調參數 → 調架構,單一變因驗證。
- 固化:納入 Code Review 標準、自動化測試管線跑效能基準。
總結
慢查詢 80% 來自 20% 核心原因:**索引缺失、SQL 寫法不當、鎖爭用、參數預設值**。建立「監控 → 分析 → 優化 → 驗證 → 固化」閉環,比記誦 50 個成因更有效。工欲善其事,必先利其器:EXPLAIN、pt-query-digest、Performance Schema、sys schema、Prometheus/Grafana 是每位 DBA/開發必備利器。