優化器基於**成本模型**選擇執行計劃。統計信息準確、索引設計合理、SQL 寫法友好,是高性能三要素。惡劣 SQL 與優質 SQL 在百萬級數據上可達**百倍性能差距**。
B+ 樹索引不存儲 NULL 值。任何包含 IS NULL 的條件直接全表掃描。
對策:業務層面避免 NULL,用默認值/空串/特殊標記替代;必須查 NULL 時建立函數索引 CREATE INDEX idx_col_null ON t((col IS NULL))(8.0+)。
-- 失效:列參與運算/函數
WHERE YEAR(create_time) = 2024
WHERE col + 0 = 123
WHERE CONCAT(first_name, last_name) = 'Bill Clinton'

-- 生效:將運算移至常量側
WHERE create_time >= '2024-01-01' AND create_time < '2025-01-01'
WHERE col = 123
WHERE first_name = 'Bill' AND last_name = 'Clinton'
原則:列保持「乾淨」,所有計算、函數、類型轉換在常量側完成。
-- 失效:% 開頭無法利用索引
WHERE name LIKE '%clinton%'

-- 生效:後置通配符可用索引
WHERE name LIKE 'clinton%'

-- 必須前置通配符時:全文索引 / 搜索引擎
ALTER TABLE t ADD FULLTEXT(name);
SELECT * FROM t WHERE MATCH(name) AGAINST('+clinton' IN BOOLEAN MODE);
ORDER BY col 若 col 無索引或方向不一致(ASC/DESC 混用),觸發 filesort。
對策:建立覆蓋索引 (where_col, order_col),或強制 ORDER BY NULL 禁止排序(不需有序結果時)。
-- 失效:否定條件通常不走索引
WHERE status != 'INVALID'
WHERE NOT (status = 'VALID')

-- 生效:改寫為正向區間
WHERE status = 'VALID'
-- 或數值型
WHERE salary < 3000 OR salary > 3000
-- 低效:IN 先執行子查詢物化臨時表
SELECT * FROM t1 WHERE id IN (SELECT id FROM t2 WHERE cond);

-- 高效:EXISTS 相關子查詢,逐行探測,命中即停
SELECT * FROM t1 WHERE EXISTS (SELECT 1 FROM t2 WHERE t2.id = t1.id AND cond);
經驗:NOT EXISTS 優於 NOT IN(後者對 NULL 語義複雜且不走索引)。
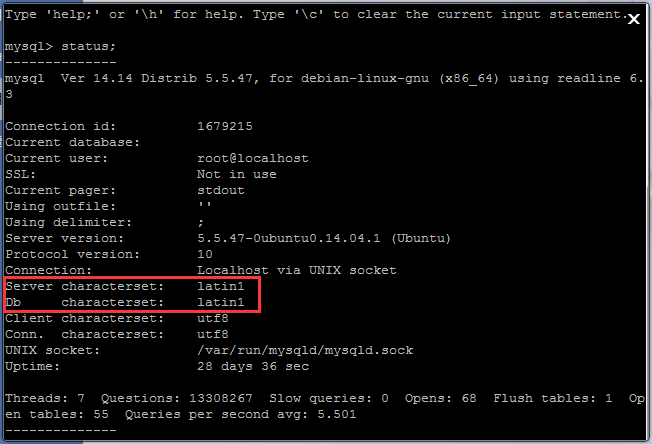
連接列/比較列字符集/校對規則不一致導致隱式轉換,索引失效。
檢查:SHOW CREATE TABLE、SHOW VARIABLES LIKE 'collation%',統一 utf8mb4_general_ci 或 utf8mb4_0900_ai_ci。
索引 (a,b,c):
✅ WHERE a=1 / WHERE a=1 AND b=2 / WHERE a=1 AND b=2 AND c=3
❌ WHERE b=2 / WHERE c=3 / WHERE a=1 AND c=3(跳過 b)
SELECT a,b FROM t WHERE c=1 → 索引 (c,a,b) 避免回表SELECT * FROM t ORDER BY id LIMIT 100000,20 → SELECT * FROM t INNER JOIN (SELECT id FROM t ORDER BY id LIMIT 100000,20) tmp USING(id)SELECT *,減少網絡/IO/緩存壓力INSERT ... VALUES (...),(...),(...)、LOAD DATA 替代循環單條執行long_query_time=1、log_queries_not_using_indexes=ON、定期 pt-query-digest 分析pt-index-usage、pt-duplicate-key-checker、pt-online-schema-change索引是雙刃劍:加速讀、拖慢寫。遵循「業務驅動建索引、SQL 適配索引、統計信息鮮度、定期審計清理」閉環,才能持續保持高性能。