若使用 fetchrow_hashref(),請留意以下幾點:
fetchrow_hashref() 並非最佳選擇,因其效率不如 fetchrow_array() 或 fetchrow_arrayref()。NAME_lc 或 NAME_uc 屬性,強制 fetchrow_hashref() 將欄位名稱轉為全小寫或全大寫。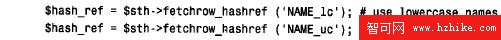
雜湊對每個唯一的欄位名稱僅保留一個元素。若執行從多個擁有相同欄位名稱的資料表中回傳欄位的連接查詢,將無法存取所有欄位值。例如:
SELECT a.name FROM a,b WHERE a.name=b.name上述查詢使用 fetchrow_hashref() 將只回傳含有一個元素的雜湊。
如何得知 SELECT 或類似查詢回傳了多少列?一種方法是在提取時計算列數,這實際上是唯一方便的方法。雖然使用 MySQL 驅動程式可在呼叫 execute() 後透過語句處理器呼叫 rows() 方法,但這對其他資料庫引擎不通用;即使對 MySQL,若已設定 mysql_use_result 屬性,rows() 也必須等到提取所有列後才能回傳正確結果。因此,只能像提取列一樣對它們進行計數。
若結果集僅含單一列,無需執行迴圈。假設要撰寫取得歷史聯盟成員當前數量的腳本 count_members,程式碼如下:
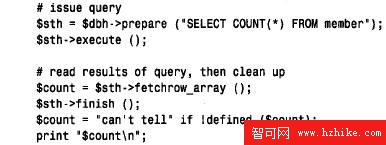
SELECT 陳述式只回傳一列,故不需迴圈;只呼叫一次 fetchrow_array()。又因只選擇一欄,甚至不需將回傳值指派給陣列。在標量環境下呼叫 fetchrow_array() 時,它回傳該列的第一欄,若無更多有效列則回傳 undef。
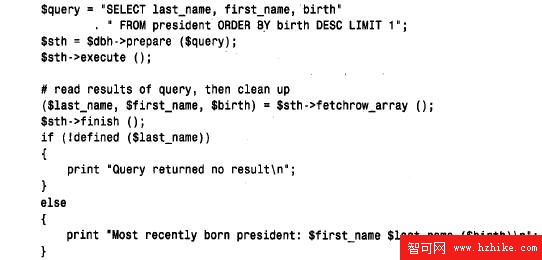
另一種預期最多一筆記錄的查詢是使用 LIMIT 1 限制回傳列數的查詢,常用於回傳特定欄位含最大或最小值的列。例如,下列查詢給出最近出生的總統姓名與出生日期:
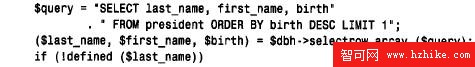
若無提取迴圈的其他查詢類型利用 MAX() 或 MIN() 選擇單一值。在所有這些情況下,取得單列結果更簡單的方法是使用資料庫處理器方法 selectrow_array(),它結合了 prepare()、execute() 並在單一呼叫中提取列。它回傳一個陣列(而非引用),若發生錯誤則回傳空陣列。前例可改寫為:
使用提取迴圈時,DBI 不提供在結果集中隨意查找的方法,或以非迴圈順序處理列。提取列後,若未保存,前一列將遺失。這不適合以下情況:
可用幾種方式整體存取結果集:完成提取迴圈並在提取時保存每列,或使用一次回傳整個結果集的方法。無論哪種方法,最終都以包含逐列矩陣結束,矩陣欄數與選擇的欄位數相同。可任意多次、以任何順序處理矩陣元素。
一種方法是使用 fetchrow_array() 並保存對這些列引用的陣列。下列程式碼除保存所有列外,還示範如何確定矩陣的列數與欄數,及如何存取矩陣個別成員:
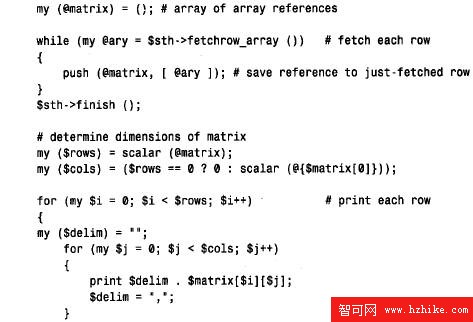
確定矩陣維度時,必須先確定列數,因為無論矩陣是否為空,都可計算欄數。若 $rows 為 0,矩陣為空且 $cols 也為 0;否則欄數可作為列陣列中元素數量計算,語法 @{$matrix[$i]} 可整體存取第 $i 列。
上述範例中,我們提取每列並保存其引用。若想直接檢索列引用,可能會想用 fetchrow_arrayref():
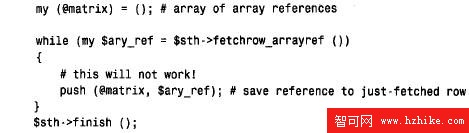
但這無法正常運作,因 fetchrow_arrayref() 重複使用引用指向的陣列,導致結果矩陣中每個元素都指向同一列——最後檢索的列。因此若想一次提取一列,必須用 fetchrow_array() 而非 fetchrow_arrayref()。
另一選擇是使用回傳整個結果集的 DBI 方法。fetchall_arrayref() 回傳對引用陣列的引用,陣列每個元素指向結果集中某列。這非常簡單有效,回傳值即為矩陣引用。使用方式:呼叫 prepare() 和 execute(),然後如下檢索結果:
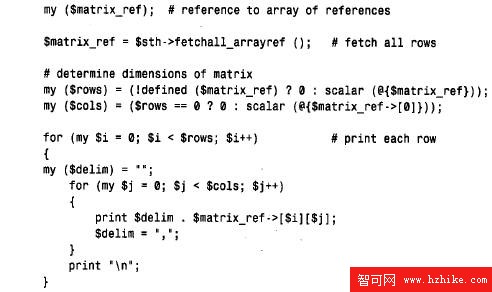
若結果集為空,fetchall_arrayref() 回傳對空陣列的引用;若發生錯誤則回傳 undef,故若未啟用 RaiseError,使用前務必檢查回傳值。列數與欄數由矩陣是否為空決定。若想以陣列存取矩陣的整個第 $i 列,應使用語法 @{$matrix_ref->[$i]}。
selectall_arrayref() 方法類似 fetchall_arrayref() 但做了更多工作:它為您完成整個 prepare()、execute()、提取迴圈、finish() 序列。使用時直接利用資料庫處理器將查詢傳遞給它:
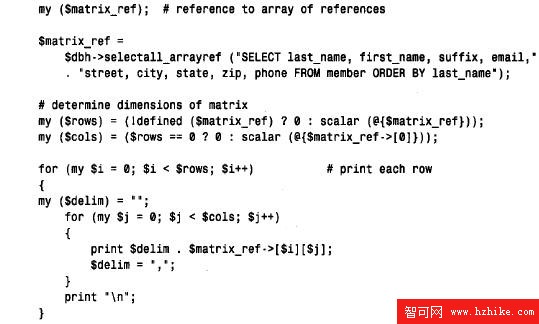
從資料庫檢索資料時,可能需區分值為 NULL、0 或空字串的欄位。因 DBI 將 NULL 欄位值作為 undef 回傳,這種區分很容易,但必須使用正確的測試。若嘗試下列程式碼片段,三次顯示皆為「false!」:
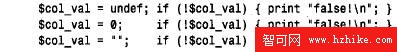
對於這兩個測試,也都顯示「false!」:

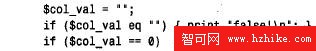
下列程式碼效果相同:
要區分 NULL 與非 NULL 欄位值,請使用 defined()。確知無 NULL 值後,可用適當測試區分其他類型值。例如:
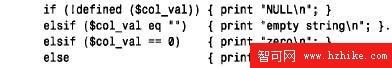
按適當順序進行這些測試很重要,因若 $col_val 為空字串,第二與第三個比較皆為真。若顛倒比較順序,會錯誤將空字串標識為 0。
迄今我們以最基本方式利用引用字串構造查詢。當引用字串包含引用值時,會在 Perl 詞彙層級產生問題。在插入或選擇包含引號、反斜線或二進位資料的值時,SQL 中也可能出問題。若指定查詢為 Perl 引用字串,必須避免查詢字串本身出現引用字元:
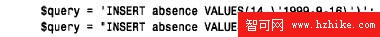
Perl 與 MySQL 皆允許用單引號或雙引號引用字串,混合使用引用字元有時可避免無法引用引用字元自身的情況:
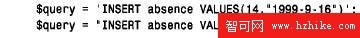
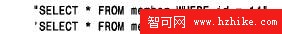
然而在 Perl 中,這兩種引號不等價。只有在雙引號內部才解釋為變量引用。因此,當想透過在查詢字串中嵌入變量引用構造查詢時,單引號不太有用。例如若 $var 值為 14,下列兩字串不等價:
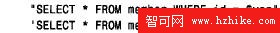
兩字串解釋如下;顯然第一字串更接近希望傳遞給 MySQL 伺服器的內容:
用雙引號引用字串的另一選擇是使用 qq{} 結構,它告訴 Perl 在 qq{ 與 } 之間的每個字元都視為雙引號括起的字串。例如下列兩行等價:
使用 qq{} 時,構造查詢毋須過多考慮引號問題,因可在查詢字串內自由使用引號(單或雙),無需避開它們;且仍解釋變量引用。這兩特性可用下列 INSERT 陳述式說明:
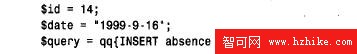
不一定用 { 和 } 作為 qq 分隔符。其他格式如 qq() 和 qq// 也可用,只要封閉分隔符不出現在字串內即可。我偏好 qq{},因 { 不像 ) 或 / 會出現在查詢文本內,且在查詢字串結尾也可能有問題。例如 ) 出現在上述 INSERT 陳述式內部,故 qq() 不適合引用查詢字串。
qq{} 結構可跨行,若想讓查詢字串在 Perl 程式碼中醒目,這很有用:
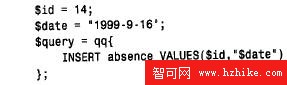
若想將查詢格式分為多行以增強可讀性,也很有用。例如 dump_members 腳本中的 SELECT 陳述式如下:

用 qq{} 改寫如下:
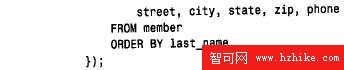
雙引號字串也可跨行,但我更偏好用 qq{} 編寫多行字串。我發現當在一行中看到不匹配的引號時,會自然地想「這會是語法錯誤嗎?」,然後浪費時間尋找匹配的引號。
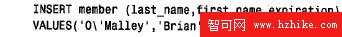
qq{} 結構在 Perl 詞彙層級解決了引用問題,故可輕易將引號放入字串內而不會使 Perl 混淆。然而仍必須考慮 SQL 層級語法。考慮向 member 資料表插入一條記錄:
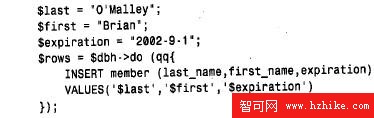
do() 發送給 MySQL 的字串如下:
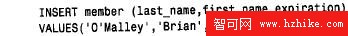
這是不合法的 SQL 陳述式,因單引號字串內出現單引號。第 6 章遇過類似引用問題,當時用 mysql_escape_string() 處理。DBI 提供類似機制——在一條語句中,對想按字面使用的每個引用值,呼叫 quote() 方法並使用其回傳值。
前例可改寫為:
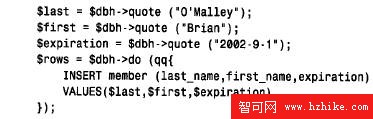
現在 do() 發送給 MySQL 的字串如下,具有出現在引用字串內的可能對伺服器轉義的引號:
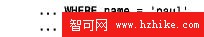
請注意,在查詢字串中引用 $last 和 $first 時,不要增加括起來的引號;quote() 方法已包含它們。若增加引號,查詢將出現過多引號:
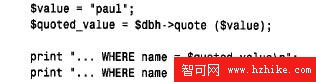
這些語句產生下列輸出:
前面各節我們透過把要插入或選擇的值直接放在查詢字串中構造查詢。不一定非要這樣做。DBI 允許在查詢字串內部放置稱為佔位符的特殊標記,然後在執行查詢時將這些值代替那些標識符使用。主要原因是提高效能,特別是在迴圈中反覆執行某查詢時。
為說明佔位符如何運作,舉例說明。假設學校新學期剛開始,打算清理學分簿的 student 資料表,然後利用檔案中的學生姓名列表將其初始化。不用佔位符,可如下刪除現有表內容並裝入新姓名:
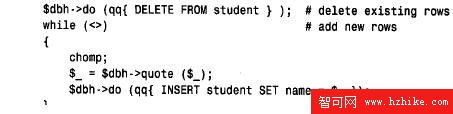
這樣效率很低,因 INSERT 查詢基本格式每次相同,且整個迴圈中 do() 每次都呼叫 prepare() 和 execute()。在進入迴圈前只呼叫一次 prepare() 設置 INSERT 陳述式,並在迴圈內只呼叫 execute(),效率更高。只呼叫一次 prepare() 可避免其他多次呼叫。DBI 允許這樣做:
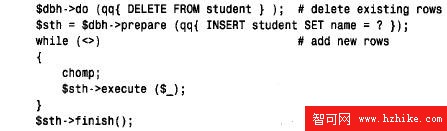
請注意 INSERT 查詢中的 ? 即為佔位符。呼叫 execute() 時,將查詢發送給伺服器,傳遞此值代替佔位符。一般來說,若發現迴圈內呼叫了 do(),應在迴圈前呼叫 prepare(),並在迴圈內呼叫 execute() 較好。
quote() 方法指定佔位符值,否則插入值中會得到額外引號。execute() 的值數相同。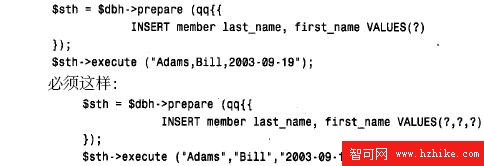
undef。除了在迴圈中提高效率外,對某些資料庫引擎,佔位符還能帶來其他效能好處。某些引擎快取了準備好的查詢及為有效執行查詢生成的計劃。若稍後伺服器收到同樣查詢,可再次使用相應計劃而無需重新生成。查詢快取對複雜 SELECT 陳述式特別有幫助,因可能需花費時間生成較好的執行計劃。佔位符提供在快取中尋找查詢的好機會,因它們使查詢比直接在查詢字串中嵌入指定欄位值構造查詢更通用。對 MySQL,此方式下佔位符不提高效能,因無查詢快取。但仍可能想用佔位符編寫查詢;若將 DBI 腳本傳遞給支援查詢快取的引擎,該腳本比無佔位符時執行效率更高。
在查詢執行時,允許在查詢字串中用佔位符代替這些值,即參數化查詢的「輸入」。在提取列而不必將值賦給變量時,DBI 也提供稱為參數約束的輸出操作,允許透過檢索自動進入這些變量的欄位值使「輸出」參數化。
假設有查詢檢索 member 資料表中的成員姓名。可告訴 DBI 將選定欄位的值賦給 Perl 變量。提取列時,變量利用相應欄位值自動更新。下例說明如何將欄位約束到變量,然後在提取迴圈中存取它們:
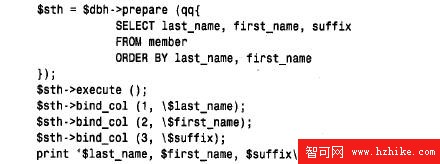
每個 bind_col() 呼叫應指定一個欄位號碼和一個希望與該欄位相聯的變量引用。欄位號碼從 1 開始。bind_col() 應在 execute() 之後呼叫。
另一選擇是單獨呼叫 bind_col(),可在 bind_columns() 的單個呼叫中傳遞全部變量引用:
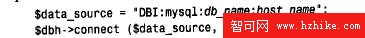
建立伺服器連接最直接的方法是呼叫 connect() 方法時指定所有連接參數:
若遺漏連接參數,DBI 會做以下處理:
DBI_DSN 環境變數。DBI_USER 和 DBI_PASS 環境變數(但若為空字串則不使用)。Windows 下若未定義用戶名,使用 user 變數。localhost。undef 或空字串,預設為 UNIX 登錄名稱。Windows 下用戶名預設為 ODBC。undef 或空字串,則不傳送口令。可透過將某些選項添加到字串初始部分(每個都在分號前)在資料來源中指定選項。例如可用 mysql_read_default_file 選項指定選項檔路徑:

執行腳本時,將從該檔案讀取連接參數。假設 /u/paul/.my.cnf 含:
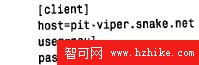
則 connect() 呼叫嘗試連接到 pit-viper-snake-net 上的 MySQL 伺服器,用口令 secret 及用戶名 paul 連接。若想允許擁有正確設置選項檔的任何人使用腳本,可這樣指定資料來源:

$ENV{HOME} 含用戶執行腳本的主目錄路徑,故腳本使用的主機名、用戶名和口令將從每個用戶自己的選項檔中抽取。以這種方式編寫腳本,不必在腳本中逐字嵌入連接參數。
還可用 mysql_read_default_group 選項指定選項檔組。這自動導致讀取用戶的 .my.cnf 檔,並除 [client] 組外,允許讀取指定選項組。例如若在 DBI 腳本中有指定選項,可將它們列在 [dbi] 組中,然後如下使用資料來源值:
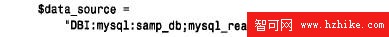
mysql_read_default_file 和 mysql_read_default_group 需 MySQL 3.22.10 或更新版本,以及 DBD::mysql 1.21.06 或更新版本。詳細資訊請參閱附錄 G 與附錄 E。
使用選項檔不妨礙在 connect() 呼叫中指定連接參數(例如想腳本作為特殊用戶連接)。connect() 中指定的任何明確主機名、用戶名和口令值將覆蓋選項檔中發現的連接參數。例如想讓腳本從命令列分析 --host、--user 和 --password 選項並使用那些值(若給定),優先於選項檔中發現的任何內容。這很有用,因這是標準 MySQL 客戶端操作方式,DBI 腳本將因此符合其行為。
對於本章開發的保留在命令列的腳本,我將使用一些標準連接設置代碼及卸載代碼。只在此說明一次,以便專注於每個腳本主體:
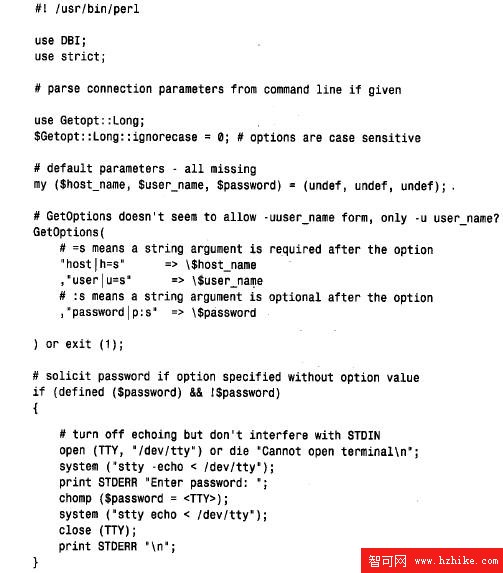
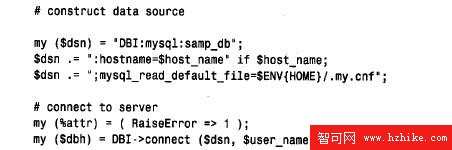
此代碼初始化 DBI,在命令列查找連接參數,然後使用命令列或用戶執行腳本的 ~/.my.cnf 檔中所發現的參數,連接到 MySQL 伺服器。若在主目錄中設置 .my.cnf 檔,執行腳本時不一定要輸入任何連接參數(記住設置這種方式,使沒有其他人讀取此檔。指導請參閱附錄 E)。
腳本最後部分也類似;它簡單地終止連接並退出:
$dbh->disconnect();
exit(0);
當我們讀到 Web 程式設計部分(即 7.4 節「在 Web 應用程式中使用 DBI」)時,將修改一些連接設置代碼,但基本思想類似。
調試有故障的 DBI 腳本時,通常用兩項技術,單獨使用或前後配合。首先,在腳本整個過程中編寫顯示語句,允許將調試輸出設計為想要的方式,但必須手工增加語句。其次,可使用 DBI 內建追蹤能力,這更通用、更系統,且開啟後自動出現。DBI 追蹤也說明除此以外無法獲得的驅動程式操作資訊。
MySQL 郵件清單常見問題:「有一個查詢,在 MySQL 中執行運行得好,但在我 DBI 腳本中不工作,怎麼回事?」尋找發布不同查詢的 DBI 腳本與提問者所期望的一樣很平常。若在執行前顯示查詢,可能驚異地看到真正發送到伺服器的內容。假設將查詢鍵入 MySQL(無終止分號):

然後在 DBI 腳本中試著做同樣事:
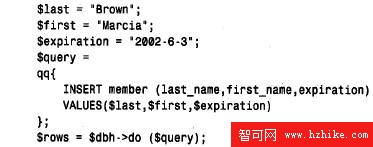
雖是同樣查詢,但不工作。試著顯示:
print "$query\n"結果如下:
INSERT member (last_name,first_name,expiration)
VALUES(Brown,Warcia,2002-6-3)
從輸出可見,忘記了 VALUES() 列表中欄位值前後的引號。指定查詢正確方法如下:
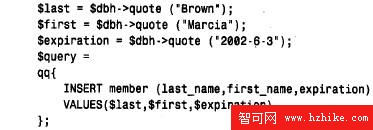
或可用佔位符指定查詢,並傳遞值直接插入 do() 方法:
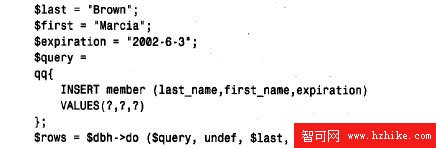
不幸的是,用佔位符時,顯示語句無法看到完整查詢樣子,因直到呼叫 do() 才能估計佔位符值。使用佔位符時,追蹤可能對調試更有幫助。
試圖查出腳本不正確工作原因時,可告知 DBI 生成追蹤(調試)資訊。追蹤級別範圍 0(關閉)到 9(最多資訊)。一般 1 和 2 最有用。級別 2 追蹤說明正在執行的查詢文本(含佔位符替換結果)、呼叫 quote() 的結果等,對捕獲問題極有幫助。
用 trace() 方法可從獨立腳本內部控制追蹤,或設定 DBI_TRACE 環境變數影響所有運行的 DBI 腳本追蹤。
用 trace() 呼叫,傳遞追蹤級別參數,可選再傳遞檔名。若未指定檔名,所有追蹤輸出到 STDERR;否則轉到命名檔案。範例如下:
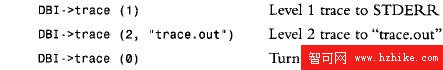
呼叫 DBI->trace() 時,追蹤所有 DBI 操作。更精細方法是用獨立處理級別啟用追蹤。若不確定腳本中問題位置,且不想插手該點出現的每件事的追蹤輸出,這很有幫助。例如特定 SELECT 查詢有問題,可追蹤與此查詢相關的語句處理器:
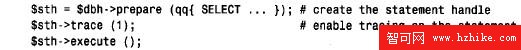
若對任何 trace() 呼叫指定檔名參數,無論對 DBI 整體或單獨處理器,所有追蹤輸出都進入該檔案。
若想對運行的所有 DBI 腳本全部開啟追蹤,從命令解釋器設定 DBI_TRACE 環境變數。語法取決於使用的命令解釋器:
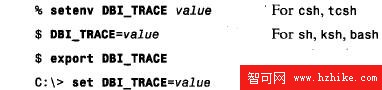
value 模式與所有命令解釋器相同:數字 n 表示在級別 n 開啟追蹤到 STDERR;檔名開啟級別 2 追蹤到命名檔案,或 n=file_name 開啟級別 n 追蹤到命名檔案。下列範例用 csh 語法:
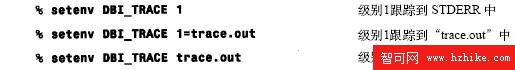
若開啟追蹤到命令解釋器中的檔案,確保一旦解決問題就關閉它。調試輸出會增加到追蹤檔而不重寫,不小心會讓檔案變得非常大。極壞的想法是在命令解釋器啟動檔(如 .cshrc、.login 或 .profile)中定義 DBI_TRACE!UNIX 下可用下列兩命令(csh 語法)之一關閉追蹤:
% setenv DBI_TRACE 0
% unsetenv DBI_TRACE
對 sh、ksh 或 bash:
$ DBI_TRACE=0
$ export DBI_TRACE
Windows 作業系統中可用下列兩命令之一關閉追蹤:
c:> unset DBI_TRACE
c:> set DBI_TRACE=0可用 DBI 獲得存取結果集中繼資料——即有關由查詢選擇列的描述資訊。透過存取與結果集生成的查詢相關的語句處理器屬性獲得此資訊。有些屬性作為可用於橫跨所有資料庫驅動程式的標準 DBI 屬性(如 NUM_OF_FIELDS,結果集中欄位數量)。另一些是 MySQL 特定的,由 DBD::mysql 提供的 DBI MySQL 驅動程式提供。這些屬性如 mysql_max_length 告知每欄位值的最大寬度,不可用於其他資料庫引擎。使用任何 MySQL 特定屬性都必須冒著使腳本不可移植到其他資料庫的風險。但它們可使更容易獲得想要的資訊。
必須在適當時候請求中繼資料。一般直到呼叫 prepare() 和 execute() 後,結果集屬性才能用於 SELECT 陳述式。除此之外,呼叫 finish() 後屬性可能變為無效。
看看如何使用 MySQL 中繼資料屬性 mysql_max_length,與保留查詢欄位名的 DBI 級別 NAME 屬性一起使用。可將這些屬性提供的資訊合併,編寫腳本 box_out,以交互模式運行 MySQL 客戶端程式時獲得的相同邊框風格,從 SELECT 查詢產生輸出。box_out 主體如下(可用任何其他陳述式替換 SELECT 語句;編寫輸出的例程獨立於特定查詢):
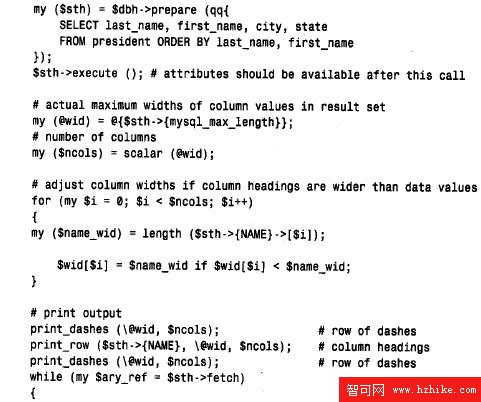
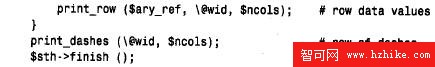
用 execute() 初始化查詢後,獲得所需中繼資料。$sth->{NAME} 和 $sth->{mysql_max_length} 給出欄位名和每欄位值的最大寬度。為在此查詢中為欄位命名,每個屬性值都引用一個陣列,含有結果集每欄位中的一個值。
剩餘計算類似於第 6 章開發的客戶端程式 5 中所用內容。例如為避免偏離輸出,若欄位名比該欄位中任何資料值都寬,則向上調整欄位寬度值。
輸出函數 print_dashes() 和 print_row() 代碼如下,也類似於客戶端程式 5 中相應代碼:
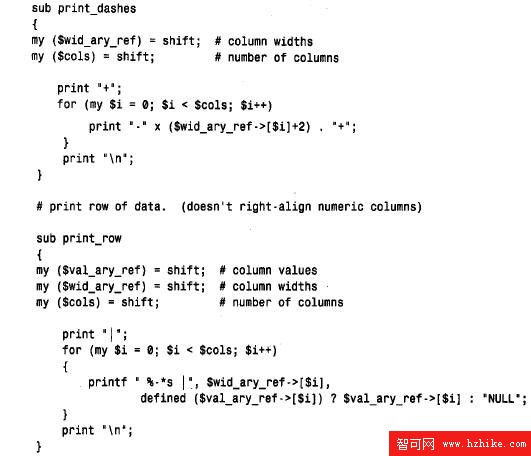
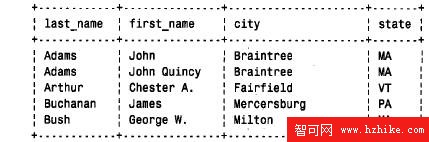
box_out 輸出如下:
下一個腳本使用欄位中繼資料產生不同格式輸出。腳本 show_member 允許快速瀏覽歷史聯盟成員項目,無需輸入任何查詢。給出成員姓,它這樣顯示所選項目:
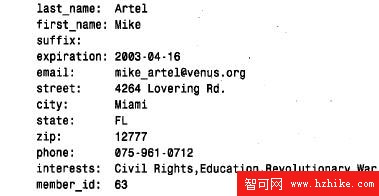
用會員資格號碼,或用與若干姓匹配的模式也可調用 show_members。下列命令說明會員號碼 23 的項目,和以字母「C」開始姓的會員項:
show_member 腳本主體如下。它用 NAME 屬性確定輸出每行所用標號,和 NUM_OF_FIELDS 屬性找出結果集含有的欄位數:
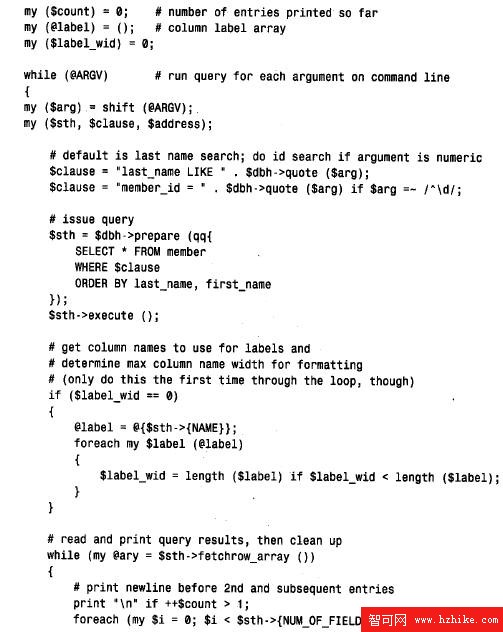
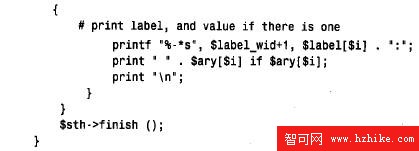
無論區域為何,show_member 目的都是說明一個項目的全部內容。透過使用 SELECT * 檢索所有欄位和 NAME 屬性看它們是什麼,即使從 member 資料表增加或刪除欄位,此腳本也能工作而無需修改。
若不檢索任何列就想知道一個資料表含哪些欄位,可發布查詢:
SELECT * FROM tbl_name WHERE 1=0正常呼叫 prepare() 和 execute() 後,可從 @{$sth->{NAME}} 得到欄位名。但請注意,雖用「空」查詢這小竅門在 MySQL 下運行,但不可移植,並非對所有資料庫引擎都工作。
有關 DBI 和 DBD::mysql 提供屬性的詳細資訊,請見附錄 G。它能讓您確定是想通過避免 MySQL 特定屬性為可移植性付出努力,還是在可移植性開銷方面利用它們。