| 現象 | 常見原因 | 核心對策 |
|---|---|---|
| Slave_IO_Running: No | 網絡不通、認證失敗、Binlog 位點無效、主庫 Binlog 已清理、max_allowed_packet 過小 | 檢查網絡/賬號 → 重新定位位點 → 調整參數 |
| Slave_SQL_Running: No | Slave 端誤寫入(1062)、行不存在(1032)、主庫語句錯誤(1053)、事務回滾 | 跳過計數器 / 手動修數據跳過 / 重新同步 |
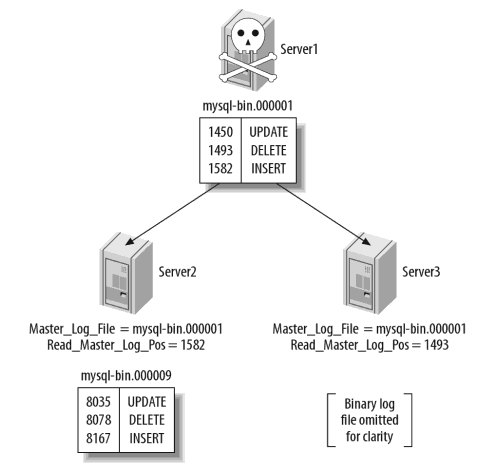
Slave 狀態:
Master_Log_File: mysqlmaster.000079
Read_Master_Log_Pos: 183913228

Master 狀態:
File: mysqlmaster.000080
Position: 13818288

錯誤日志:
[ERROR] Error reading packet from server: Client requested master to start replication from impossible position (server_errno=1236)
[ERROR] Got fatal error 1236: 'Client requested master to start replication from impossible position'
[Note] Slave I/O thread exiting, read up to log 'mysqlmaster.000079', position 183913228主庫意外斷電/崩潰,導致 mysqlmaster.000079 未正常關閉(Warning: this binlog was not closed properly),且該文件最大位點 < 183913228。Slave 請求的位點在主庫不存在。
CHANGE MASTER TO MASTER_LOG_POS=183913220 → 無效(文件本身損壞/截斷)STOP SLAVE;CHANGE MASTER TO MASTER_LOG_FILE='mysqlmaster.000080', MASTER_LOG_POS=0;START SLAVE; → 成功恢復代價:mysqlmaster.000079 中未同步的事務將永久丟失。生產環境需從備份恢復補齊。
Last_Errno: 1053
Last_Error: Query partially completed on the master (error on master: 1053) and was aborted.
Query: 'INSERT INTO hx_stat_record ...'STOP SLAVE;
-- 在 Slave 手動執行報錯的那條 SQL
INSERT INTO hx_stat_record ...;
SET GLOBAL SQL_SLAVE_SKIP_COUNTER = 1;
START SLAVE;驗證:Slave_IO_Running: Yes、Slave_SQL_Running: Yes,幾分鐘內追平積壓。
現象:IO 線程無法連接,錯誤日志顯示 Access denied for user 'repl'@'slave_ip'
排查:
1. Master 檢查用戶:SELECT User, Host FROM mysql.user WHERE User='repl';
2. 確認 Host 匹配(% / 具體 IP)
3. 確認密碼正確
4. FLUSH PRIVILEGES;
STOP SLAVE;
SET GLOBAL SQL_SLAVE_SKIP_COUNTER = N;  -- N=1 普通, N=2 涉及自增
START SLAVE;STOP SLAVE;
CHANGE MASTER TO
MASTER_HOST='master_ip',
MASTER_USER='repl_user',
MASTER_PASSWORD='password',
MASTER_LOG_FILE='mysql-bin.0000XX',
MASTER_LOG_POS=YYY;
START SLAVE;FLUSH TABLES WITH READ LOCK; SHOW MASTER STATUS; mysqldump ...; UNLOCK TABLES;RESET SLAVE; → CHANGE MASTER TO MASTER_AUTO_POSITION=1 (GTID) 或指定 File/Pos → START SLAVE| 層面 | 措施 |
|---|---|
| 架構 | GTID 模式 + ROW 格式 + log-slave-updates + read_only=1 |
| 參數 | expire_logs_days=7, max_binlog_size=100M, slave_net_timeout=60 |
| 監控 | IO/SQL 線程狀態、Seconds_Behind_Master、Binlog/Relay Log 磁碟佔用、錯誤日志關鍵字 |
| 演練 | 季度模擬:主庫掛掉→提升 Slave→應用切換→原 Master 接回為 Slave |
| 校驗 | 月度 pt-table-checksum 校驗核心表一致性 |
🔴 IO 斷 = 連不上/找不到日志 → 查網絡、查賬號、查位點、換新文件
🔴 SQL 斷 = 執行出錯 → 看錯誤碼:1062/1032 跳過或補數據,1053 手執行再跳過
🟢 動手前必備份,跳過前看清 SQL,修復後必驗證一致性
MySQL 主從故障 80% 集中在 Binlog 位點失效 和 SQL 執行衝突。掌握 CHANGE MASTER TO 重新定位與 SQL_SLAVE_SKIP_COUNTER 跳過兩大核心工具,配合 GTID 模式簡化位點管理,建立「監控告警 → 定位分類 → 標準化修復 → 事後複盤」閉環,才能駕馭復制鏈路穩定運行。