場景
將海量單表按主鍵、時間或條件字段拆分為多張表,甚至分散至多台 MySQL 實例。核心挑戰:跨分片批量查詢聚合。
應用層實現:SelectThreadManager 多線程協調器
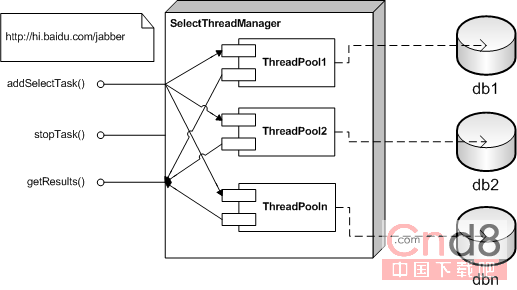
- 為每個分片建立獨立 ThreadPool。
addTask() 分發查詢任務;stopTask() 取消;getResult() 聚合結果。- 整體耗時 = 最慢分片查詢時間;設定全局超時兜底。
ThreadPool 忙碌時的處理流程
- 新任務進入該 ThreadPool 排隊。
- 外層應用收集其他分片結果,繼續等待。
- 達到超時時間 → 調用
stopTask() 設置停止標記 → 外層返回部分結果。
- 稍後 ThreadPool 取到該任務,檢測到停止標記直接結束線程。
JDBC 層透明攔截方案
- 封裝 JDBC Driver,攔截
PreparedStatement/Statement.executeQuery()。
- 內部委派給
SelectThreadManager 執行分片查詢與聚合。
- 業務代碼無感知,遷移成本極低。
MySQL 5.1 Partition 與手工分表的差異
- Partition 由 Server 內部並行掃描多個分區檔案,解決 I/O 瓶頸。
- 無法解決 CPU 計算瓶頸(單線程執行計劃),高併發複雜查詢仍需手工分表+應用層並行。