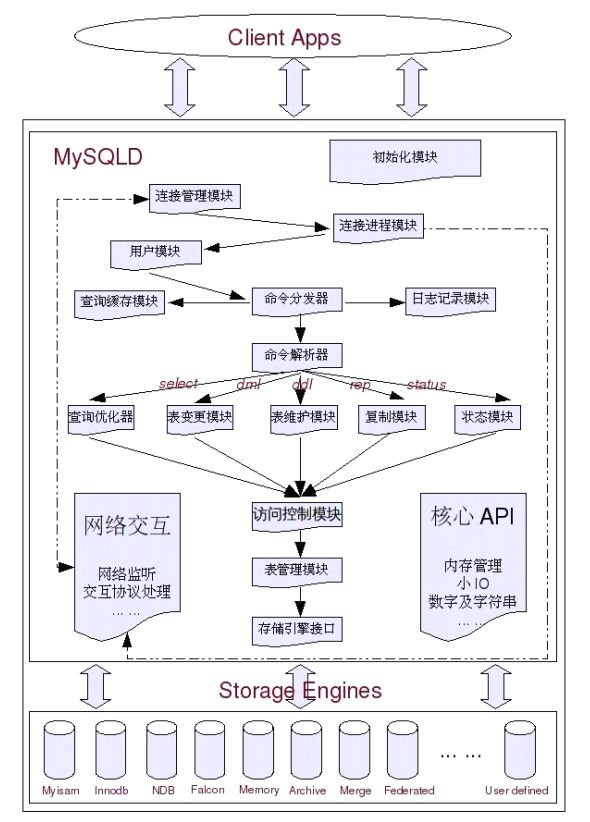
| 引擎 | 特點 | 鎖粒度 | 事務 | 適用場景 |
|---|---|---|---|---|
| MyISAM | .frm/.MYD/.MYI 三檔,B-Tree/R-Tree/Fulltext 索引 | 表鎖 | ❌ | 唯讀/讀多寫少、全文檢索、COUNT(*) 極快 |
| InnoDB | 表空間、MVCC、行鎖、外鍵、自適應哈希索引 | 行鎖 | ✅ ACID | 高併發 OLTP、需事務、混合讀寫 |
| Memory | 純記憶體、Hash/B-Tree 索引、不支援 BLOB/TEXT | 表鎖 | ❌ | 臨時表、查找表、極速讀取、重啟資料消失 |
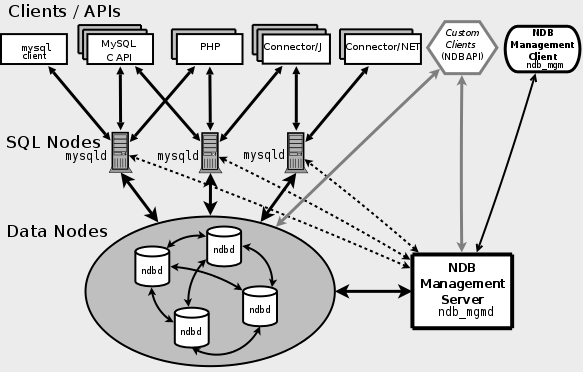
| NDB Cluster | 分散式、共享無、自動分片、同步複寫 | 行鎖 | ✅ | 高可用叢集、電信級應用 |
| Archive | 壓縮存儲、僅支援 INSERT/SELECT、行鎖 | 行鎖 | ❌ | 歷史日誌、審計軌跡、極少讀取 |
| CSV | 標準 CSV 檔案、無索引 | 表鎖 | ❌ | 報表匯出、異構交換 |
| Blackhole | 「黑洞」,寫入不存儲、主從同步中繼 | 無 | ❌ | Binlog 過濾、多源同步轉發 |
| Federated | 遠程表映射、類 Oracle DBLink | 遠程 | ❌ | 跨實例查詢、遷移過渡期 |
| Merge | 多 MyISAM 表聯合視圖、結構必須完全一致 | 表鎖 | ❌ | 分區表前身、日誌分表查詢 |
| BDB | BerkeleyDB、頁鎖、支援事務 | 頁鎖 | ✅ | 歷史產品,已少見 |
例:論壇貼文計數「即時更新」vs「定時批次」——前者需高併發寫入優化,後者可接受延遲。
不適合存入 DB: 二進位多媒體、流水隊列、超大文本。
適合 Cache: 系統配置、活躍用戶資料、個性化設定、準實時統計。
同樣需求,不同寫法效能相差百倍。核心案例:
-- 方案一:大表先 JOIN 再 LIMIT(掃描 3 萬行)
SELECT id, nick_name FROM user, user_group
WHERE user_group.group_id=1 AND user_group.user_id=user.id
ORDER BY user_group.gmt_create DESC LIMIT 100,20;

-- 方案二:先在小表取 ID 再 JOIN(僅 20 行參與 JOIN)
SELECT user.id, user.nick_name
FROM (SELECT user_id FROM user_group WHERE group_id=1 ORDER BY gmt_create DESC LIMIT 100,20) t
JOIN user ON t.user_id = user.id;
方案二經優化器驗證,rows 從 31156 降至 20,效能提升數量級。
| 應用類型 | CPU | 記憶體 | 磁碟 IOPS | 磁碟吞吐 | 網路 |
|---|---|---|---|---|---|
| OLTP(高併發、小隨機 IO) | 強多核 | 大(熱數據全記憶體) | 極高(SSD/NVMe) | 次要 | 千兆以上 |
| OLAP(大順序掃描、低併發) | 中等 | 中等 | 中等 | 極高(大頻寬 RAID/分散式) | 集群內萬兆 |
| 高頻小查詢(DNS/查找服務) | 強單核 | 極大(全量記憶體) | 低 | 低 | 千兆 |
| 鎖類型 | 引擎代表 | 特點 |
|---|---|---|
| 表鎖 | MyISAM, Memory, CSV | 開銷最小、併發最差、死鎖概率零 |
| 行鎖 | InnoDB, NDB | 併發最高、開銷大、可能死鎖 |
| 頁鎖 | BDB | 折中、易產生碎片 |
EXPLAIN 入手分析執行計畫PROFILE / PERFORMANCE_SCHEMA 精準計時ORDER BY 用索引序)SELECT *)=/IN/<=>,無序、不支援範圍、不支援部分鍵、遇大量碰撞效能劣化。LIKE '%kw%' 低效,僅 CHAR/VARCHAR/TEXT 可建。WHERE/JOIN/ORDER BY 欄位 → 建索引WHERE → 不建索引ORDER BY/GROUP BY/DISTINCT 優化:鬆散/緊湊索引掃描、filesort 參數調優學習路徑: 架構認知 → 引擎選型 → 鎖機制 → 硬體規劃 → Query 原則 → 索引實戰 → JOIN/排序優化 → Schema 重構 → 架構演進。每一層都要以
EXPLAIN與監控數據為證,拒絕經驗主義。