索引是為特定列構建的**有序數據結構**(MySQL 默認 B+ 樹),將「全表掃描」的 O(N) 降為「樹高掃描」的 O(log N):**掃描 20 行定位原本需 2^20 行的數據**。
EXPLAIN SELECT `birthday` FROM `user` WHERE `birthday` < '1990/2/2';
核心列解讀:
| 列 | 含義 | 優化關注點 |
|---|---|---|
| type | 訪問類型 | 從好到壞:system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALL。**至少達到 range,最好 ref/eq_ref**。 |
| possible_keys | 理論可用索引 | 為空說明無索引可用,需檢查 WHERE 條件列。 |
| key | 實際使用索引 | NULL 表示全表掃描;PRIMARY 表示走主鍵。 |
| key_len | 索引長度 | 越短越好(不失精度前提下)。 |
| ref | 配合 key 使用的列/常量 | const 表示常量匹配。 |
| rows | 預估掃描行數 | **核心指標**,越小越快(InnoDB 不準但趨勢對)。 |
| Extra | 額外資訊 | ❌ Using filesort、Using temporary;✅ Using index(覆蓋索引)、Using where。 |
| 類型 | 特點 | 適用場景 |
|---|---|---|
| PRIMARY KEY | 唯一、非空、單表唯一 | 主鍵標識 |
| UNIQUE | 唯一、允許 NULL(多個 NULL) | 業務唯一鍵(郵箱、身份證) |
| INDEX (NORMAL) | 允許重複、允許 NULL | 普通查詢加速 |
| FULLTEXT | 全文檢索,僅 MyISAM/5.6+ InnoDB 支持,中文需分詞器 | 文章搜索(生產建議用 Elasticsearch/Coreseek/Xunsearch) |
INT(4B) < BIGINT(8B);CHAR 定長適合固定長度(MD5、UUID),VARCHAR 適合變長。DATETIME 存時間,不用字符串;用 INT UNSIGNED 存 IP(INET_ATON/INET_NTOA)。創建 INDEX idx_c1_c2 (c1, c2) 等價於擁有三個索引:
(c1, c2)(c1)(c2)、(c2, c1)規則:查詢必須從索引**最左列開始連續匹配**,遇到範圍查詢(>、LIKE %...)停止。
WHERE c1=1 AND c2=2      -- ✅ 用到 (c1,c2)
WHERE c1=1               -- ✅ 用到 (c1)
WHERE c2=2               -- ❌ 無法用到索引
WHERE c1>1 AND c2=2      -- ⚠️ 僅用到 (c1),c2 失效
| 操作 | 語法 |
|---|---|
| 建表時創建 | CREATE TABLE t (id INT PRIMARY KEY, name VARCHAR(20), KEY idx_name(name)); |
| 事後添加 (ALTER) | ALTER TABLE t ADD INDEX idx_name(name); / ADD UNIQUE uk_email(email); / ADD PRIMARY KEY(id); |
| CREATE INDEX | CREATE INDEX idx_name ON t(name); / CREATE UNIQUE INDEX uk_email ON t(email); |
| 查看 | SHOW INDEX FROM t \G; |
| 刪除 | DROP INDEX idx_name ON t; / ALTER TABLE t DROP INDEX idx_name; / ALTER TABLE t DROP PRIMARY KEY; |
| 修改 | **不支持直接修改**,刪除重建。 |
count(DISTINCT col)/count(*) 越大越好。性別(0.5)不如年齡(高)。INDEX idx_title(title(10))。判斷標準:COUNT(DISTINCT LEFT(title,10))/COUNT(*) > 0.31(黃金分割點)。-- 1. 索引列參與計算 WHERE age + 10 = 30 -- 2. 索引列使用函數 WHERE LEFT(date_col, 4) < 1990 WHERE YEAR(create_time) = 2023 -- 3. LIKE 以通配符開頭 WHERE name LIKE '%keyword%' -- 不走索引 WHERE name LIKE 'prefix%' -- 走索引 -- 4. 正則表達式 WHERE name REGEXP 'pattern' -- 5. 字符串與數字隱式轉換 CREATE TABLE a (a CHAR(10)); EXPLAIN SELECT * FROM a WHERE a = '1'; -- 走索引 EXPLAIN SELECT * FROM a WHERE a = 1; -- ❌ 不走索引(隱式 CAST) -- 6. OR 條件未全覆蓋索引 WHERE indexed_col = 1 OR non_indexed_col = 2 -- 全表掃描 -- 建議:拆分為 UNION ALL 或確保所有 OR 列都有索引 -- 7. 優化器判斷全表掃描更快 -- 小表、高選擇率、統計資訊過期等
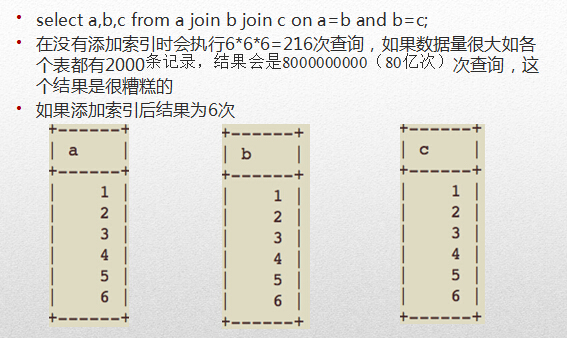
LEFT JOIN、被驅動表關聯列必須有索引。索引是 B+ 樹,核心在於**最左前綴**、**高區分度**、**覆蓋索引**、**避免函數/計算破壞順序**。用 EXPLAIN 看 type、key、rows、Extra。**優化不是加索引,而是「對的地方加對的索引」。**