聚集索引(Clustered Index,又稱聚簇索引)是 InnoDB 存儲引擎的核心架構特徵,決定了資料的物理存儲順序與查詢訪問路徑。本文深度剖析聚集索引與非聚集索引的定義差異、InnoDB IOT(索引組織表)與 MyISAM HOT(堆組織表)的對比、聚集索引選擇規則、B+ 樹葉子節點結構,以及優缺點權衡與實戰建議。
一、核心概念辨析
| 維度 | 聚集索引 | 非聚集索引(輔助索引) |
|---|
| 定義 | 索引鍵值邏輯順序 = 資料行物理存儲順序 | 僅對資料列建立索引,不影響物理存儲順序 |
| 別稱 | 聚簇索引 | 二級索引、普通索引 |
| 每表數量 | 僅 1 個 | 可多個 |
| 葉子節點內容 | 完整行資料 | 索引鍵值 + 主鍵值(InnoDB)或 物理指針(MyISAM) |
二、InnoDB (IOT) vs MyISAM (HOT) 存儲模型對比
InnoDB:索引組織表 (Index Organized Table)
- 資料即索引,索引即資料。主鍵 B+ 樹葉子節點直接包含完整行。
- 物理存儲順序遵循主鍵順序(單調遞增時為順序寫入)。
- 輔助索引葉子節點存儲主鍵值,查詢需「雙重查找」(輔助索引 → 主鍵索引)。
MyISAM:堆組織表 (Heap Organized Table)
- 資料檔(
.MYD)按插入時間順序存儲,無序。
- 所有索引(含主鍵)為非聚集,葉子節點存儲資料行物理偏移量(指針)。
- 主鍵與唯一索引結構相同,無聚集索引概念。
三、聚集索引優勢與劣勢
✅ 優勢
- 範圍查詢極快:主鍵有序,
WHERE id BETWEEN 100 AND 200 可順序讀取葉子頁,發揮預讀優勢。
- 熱點資料訪問高效:小部分高頻資料聚集在少數頁,緩存命中率高。
- 主鍵點查最快:單次 B+ 樹遍歷直達資料,無回表開銷。
- 頻繁更新不易產生碎片:若主鍵不更新,行物理位置固定,避免頁分裂與碎片。
❌ 劣勢
- 離散插入效能差:隨機主鍵(UUID、MD5)導致大量隨機 I/O、頁分裂、碎片爆增。
- 輔助索引佔用更大空間:葉子節點存主鍵值(8 字節 BIGINT),而非 4-6 字節物理指針。
- 全表掃描較慢:需掃描完整 B+ 樹葉子節點鏈表,比 MyISAM 顺序掃描資料檔慢。
四、InnoDB 聚集索引選擇規則(優先級遞減)
- 顯式定義的
PRIMARY KEY;
- 首個
NOT NULL UNIQUE 索引;
- 內建 6 字節
ROW_ID(單調遞增,不可見、不可用於查詢)。
推論: 主鍵必是聚集索引,但聚集索引未必是主鍵(無主鍵時)。
五、B+ 樹葉子節點結構圖解
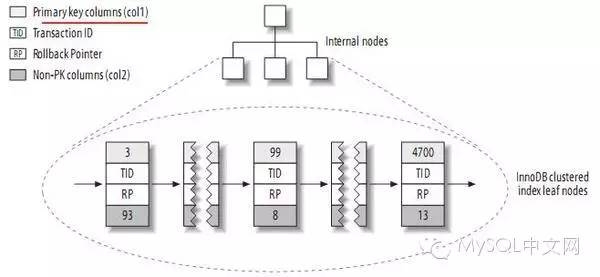
葉子節點包含:
- Key:主鍵值
- Value:其餘所有欄位值 + 隱藏列(
ROW_ID、rollback pointer、trx_id)
- 雙向鏈表指針:支援範圍掃描與反向掃描
六、實戰設計建議
- 強制指定自增主鍵:即使業務有天然鍵,也建議
id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY,業務鍵加 UNIQUE 索引。
- 避免「主鍵更新」業務:若必須變更業務鍵,只更新唯一索引欄位,主鍵不動。
- 覆蓋索引優化輔助索引查詢:將高頻查詢欄位加入聯合索引,實現「索引覆蓋」,避免回表。
- 大表拆分/分區:單表超過 2000 萬行或 20GB 考慮分區或分庫分表,控制 B+ 樹高度。
七、總結
聚集索引是 InnoDB 效能的基石。理解「資料即索引、索引即資料」的 IOT 架構,掌握主鍵選擇規則、B+ 樹葉子結構、優缺點權衡,並遵循「自增、不變、無業務含義」主鍵設計原則,是構建高效能 MySQL 系統的必修課。