UNION 與 JOIN 是多表數據融合的兩大核心操作,但本質截然不同:UNION 是「縱向疊加行」,JOIN 是「橫向拼接列」。本文通過實例對比、Hive 兼容性說明、UNION ALL 去重機制、GROUP BY 替代方案,幫助你精準選型。
| 維度 | UNION | JOIN |
|---|---|---|
| 操作方向 | 縱向 (行合並) | 橫向 (列拼接) |
| 列要求 | 列數、類型、順序**完全一致** | 無列要求,通過 ON 條件關聯 |
| 結果行數 | 集合運算 (並集/全並集) | 笛卡爾積子集 (依條件過濾) |
| 典型場景 | 分表查詢合並、歷史+當前、多源匯總 | 主外鍵關聯、多維度分析 |
-- 測試表
CREATE TABLE tmp_a (name VARCHAR(20), num INT);
CREATE TABLE tmp_b (name VARCHAR(20), num INT);
INSERT INTO tmp_a VALUES ('libingxue', 1001), ('yuwen', 1002);
INSERT INTO tmp_b VALUES ('libingxue', 1001), ('feiyao', 1003);

-- UNION (去重)
SELECT * FROM tmp_a UNION SELECT * FROM tmp_b;
-- 結果: 3 行 (libingxue 1001 僅保留 1 行)

-- UNION ALL (不去重)
SELECT * FROM tmp_a UNION ALL SELECT * FROM tmp_b;
-- 結果: 4 行 (libingxue 1001 保留 2 行)
-- Hive 必須在子查詢中使用 UNION
SELECT * FROM (SELECT * FROM tmp_a UNION ALL SELECT * FROM tmp_b) t1;
-- 必須加別名 t1,且只支援 UNION ALL
-- 同樣數據
SELECT * FROM tmp_a a JOIN tmp_b b ON a.name = b.name;
-- 結果: 1 行 (libingxue 1001 | libingxue 1001) - 內連接

SELECT * FROM tmp_a a LEFT JOIN tmp_b b ON a.name = b.name;
-- 結果: 2 行 (yuwen 1002 | NULL NULL) - 左連接保留左表所有行
-- 場景: 兩表結構相同,需合並去重
-- 方案 A: UNION ALL + GROUP BY
SELECT user_id, shop_id, MAX(auction_id), MAX(search_time)
FROM (
    SELECT * FROM tmp_resource
    UNION ALL
    SELECT * FROM tmp_result
) t1
GROUP BY user_id, shop_id;

-- 方案 B: JOIN (需主鍵關聯)
SELECT t1.user_id, t1.shop_id, t2.auction_id, t2.search_time
FROM tmp_resource t1
JOIN tmp_result t2 ON t1.user_id = t2.user_id AND t1.shop_id = t2.shop_id;
UNION / UNION ALL + GROUP BY;否 → UNION ALLUNION ALL 避免去重排序開銷;小表 → UNION 可接受SELECT *, 'source_a' AS src FROM a UNION ALL SELECT *, 'source_b' FROM b
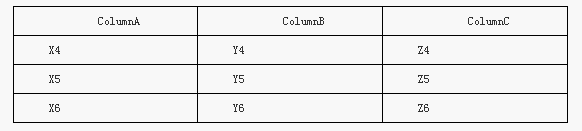
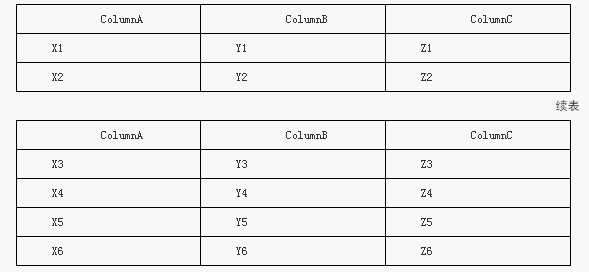
SELECT * FROM Table1 UNION SELECT * FROM Table2;
UNION 隱式去重導致性能暴跌UNION ALL + 應用層/索引去重SELECT col1, CAST(col2 AS INT), col3 FROM a UNION SELECT col1, col2, col3 FROM bJOIN 無條件產生笛卡爾積ON 條件,或用 CROSS JOIN 顯式聲明LEFT JOIN 右表非唯一導致行數膨脹